estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/varianza-y-desvio-estandar
Varianza y desvío estándar
Las dos medidas de dispersión más usadas: cómo se calculan, qué significan y por qué una se informa y la otra casi nunca.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
La varianza es, casi, el promedio de los desvíos respecto de la media, elevados al cuadrado: en una muestra se divide por y no por (ver por qué). El desvío estándar es su raíz cuadrada.
La notación distingue de dónde sale cada uno, como en todo el resto del sitio:
| Población | Muestra | |
|---|---|---|
| Varianza | ||
| Desvío estándar | ||
| Divisor |
2 · Para qué sirven
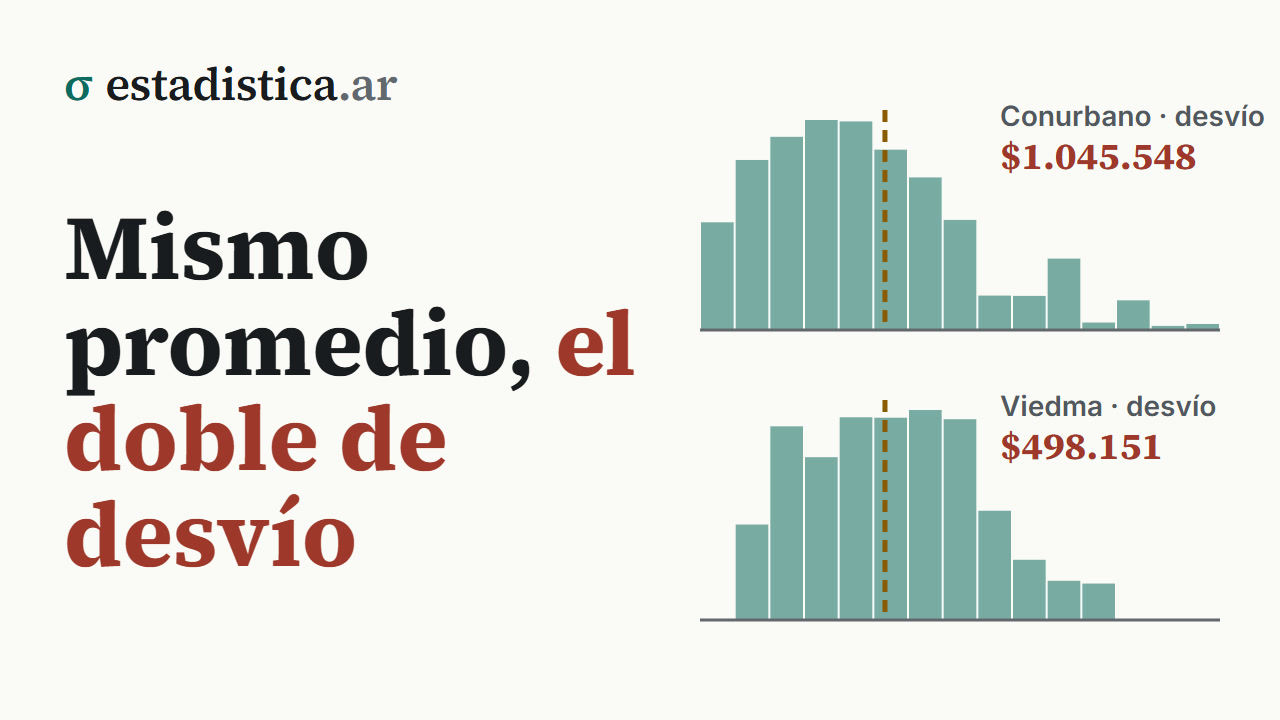
Una medida de posición sola no describe nada. Dos grupos pueden tener el mismo ingreso medio y realidades completamente distintas: en uno todos ganan parecido, en el otro hay pobreza y riqueza.
El desvío estándar cuantifica esa diferencia. Y además es la base de casi toda la Estadística posterior: el puntaje z, el error estándar, los intervalos de confianza y las pruebas de hipótesis están todos construidos sobre él.
3 · Por qué el cuadrado, y por qué después la raíz
Sin el cuadrado la cuenta daría siempre cero. Es una propiedad de la media:
Los apartamientos hacia arriba compensan exactamente a los de abajo. Hay dos formas de evitar esa compensación: tomar el valor absoluto —lo que da el desvío medio— o elevar al cuadrado.
Se elige el cuadrado por dos razones: es derivable, lo que permite trabajar algebraicamente con él, y penaliza más los apartamientos grandes, lo que resulta deseable en muchos contextos. El costo es que exagera el efecto de los valores extremos.
Y la raíz, por las unidades. Si la variable está en pesos, la varianza está en pesos al cuadrado, que no significa nada. La raíz devuelve la medida a la escala original y la vuelve interpretable. La varianza aparece igual en todas las fórmulas —es la que tiene las propiedades matemáticas útiles— pero en un informe va el desvío estándar.
4 · El procedimiento
Paso 1. Calculá la media. Paso 2. Restá la media a cada valor: esos son los desvíos. Paso 3. Elevá cada desvío al cuadrado. Paso 4. Sumalos. Paso 5. Dividí por (ver por qué). Paso 6. Sacá la raíz cuadrada.
5 · Las propiedades que la hacen útil
Tres reglas simples explican por qué la Estadística eligió la varianza y no otra medida de dispersión:
| Si… | Entonces | En palabras |
|---|---|---|
| Sumar una constante no cambia la dispersión | ||
| Cambiar de unidad la escala al cuadrado | ||
| e no correlacionadas | Las varianzas se suman |
La primera dice que la dispersión mide separación y no ubicación. La segunda, que al pasar de pesos a miles de pesos el desvío se divide por mil pero la varianza por un millón — de ahí que el desvío sea el que se informa.
6 · Un ejemplo
Dos variables de la EPH del primer trimestre de 2026:
| Ingreso | Edad | |
|---|---|---|
| Media | $1.104.227 | 41,0 años |
| Desvío estándar | $1.063.114 | 12,9 años |
| Coeficiente de variación | 96,3 % | 31,4 % |
El ingreso es el de los ocupados que lo declararon y la edad, la de los ocupados de 15 a 74 años. Las dos, con ponderadores.
El desvío del ingreso es casi igual a su media: la dispersión es enorme. El de la edad es menos de un tercio de la media: los ocupados son mucho más parecidos entre sí en edad que en ingreso.
Esa comparación no se puede hacer directamente con los desvíos —uno está en pesos y el otro en años—: hace falta el coeficiente de variación, que los vuelve comparables.
7 · Cómo se informa
La edad media fue de 41,0 años (DE = 12,9).
Se usa “DE” o “SD”, y siempre entre paréntesis después de la media. Escribir “41,0 ± 12,9” también es correcto, pero tiene un riesgo: se confunde con un intervalo de confianza, que es otra cosa. Conviene aclarar qué es lo que sigue al signo.
Y si los datos vienen de una encuesta con diseño muestral, el desvío se calcula con los ponderadores, igual que la media: el desvío sin pesos describe a la muestra y no a la población.
8 · Errores frecuentes
- Confundir desvío estándar con error estándar. El desvío describe la dispersión de los datos; el error estándar, la de la media muestral. El segundo es mucho más chico y se achica al crecer . Es la confusión más frecuente de toda la materia.
- Informar la varianza. Está en unidades al cuadrado. Va el desvío.
- Informar “media ± desvío” en distribuciones muy asimétricas. Sugiere un rango simétrico que no existe.
- Comparar desvíos de variables en distintas unidades. Para eso está el coeficiente de variación.
- Calcularlo sobre una variable nominal. No hay distancias que promediar; la dispersión de una cualitativa se mide de otra manera.
- Promediar las varianzas de varios grupos. Falta la parte que aportan las diferencias entre los promedios de cada grupo.
- Usar la fórmula con cuando corresponde . Excel tiene funciones separadas y elegir mal la función es un error silencioso.
- Usar la fórmula abreviada con números grandes. Da resultados sin cifras significativas, y a veces varianzas negativas.
- Olvidar que no es robusto. Un solo valor extremo lo infla mucho. Si el desvío parece desproporcionado, revisá los extremos antes de interpretarlo.
9 · En el software
# R — usa n−1 siempre
sd(datos$edad)
var(datos$edad)

# Con ponderadores. as.numeric(): con columnas enteras, el producto
# peso × ingreso se pasa del máximo entero de R y wtd.var() devuelve NA
sqrt(Hmisc::wtd.var(as.numeric(datos$ingreso), datos$ponderador))
# Python — ojo con el grado de libertad
import numpy as np
datos["edad"].std() # pandas usa n−1 por defecto
np.std(datos["edad"]) # NumPy usa n por defecto
np.std(datos["edad"], ddof=1) # para que coincida con pandas y R
# Con ponderadores
x, w = datos["ingreso"], datos["ponderador"]
m = np.average(x, weights=w)
np.sqrt(np.average((x - m)**2, weights=w))
# Ojo: np.cov(x, aweights=w) normaliza distinto y da otro númeroExcel: =DESVEST.M(rango) muestra, n−1 ← la que casi siempre va
=DESVEST.P(rango) población, n
=VAR.S / =VAR.P lo mismo para la varianza (ojo: VAR.S,
no VAR.M, aunque el desvío sea DESVEST.M)
SPSS: Analizar › Estadísticos descriptivos › Descriptivos › Opciones
› Desviación estándar (usa n−1)Herramientas de este tema
- CalculadoraDescriptivos desde datos pegados
- PlantillaDescriptivos totales y por grupo
Seguir leyendo
Bioestadística · Fundamentos y descripción · 39 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 38 de 318
Probabilidad y Estadística · Fundamentos y descripción · 39 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 35 de 288
Estadística para la tesis · Los datos · 86 de 233
Cómo citar: Montivero, J. L. (2026). Varianza y desvío estándar. estadistica.ar. https://estadistica.ar/conceptos/varianza-y-desvio-estandar
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Varianza y desvío estándar. estadistica.ar. https://estadistica.ar/conceptos/varianza-y-desvio-estandar
BibTeX
@misc{estadistica_ar_varianza_y_desvio_estandar,
  author       = {Montivero, Jorge Luis},
  title        = {{Varianza y desvío estándar}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/varianza-y-desvio-estandar}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.