estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/coeficiente-de-variacion
Coeficiente de variación
La dispersión relativa a la media: la medida que permite comparar la variabilidad de dos variables medidas en unidades distintas.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
El coeficiente de variación es el desvío estándar expresado como porcentaje de la media:
2 · Para qué sirve
Un desvío estándar de 12,9 años y otro de $1.063.114 no se pueden comparar: están en unidades distintas y en escalas distintas. El coeficiente de variación resuelve las dos cosas a la vez, porque divide por la media.
Sus dos usos habituales:
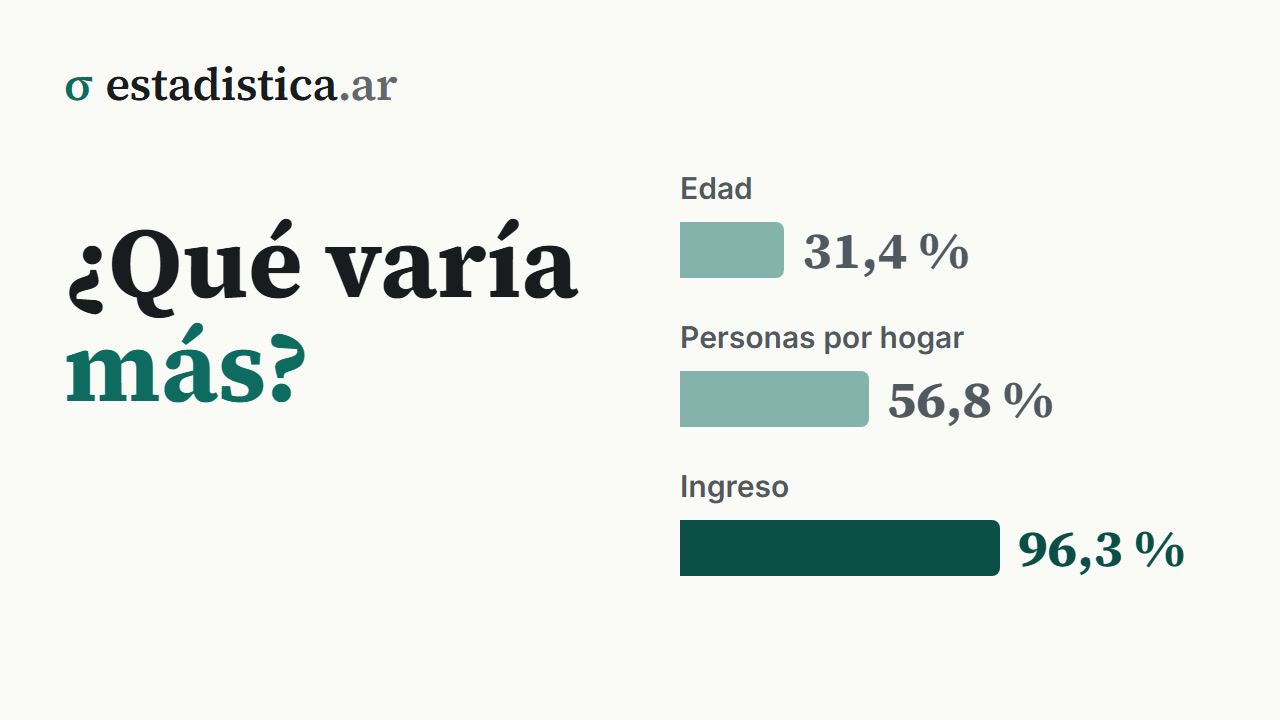
Comparar variables distintas. ¿Los ocupados son más heterogéneos en edad o en ingreso? Sin el CV la pregunta no tiene respuesta.
Comparar el mismo fenómeno en escalas distintas. La variabilidad de los pesos de recién nacidos y la de adultos: el desvío absoluto del adulto va a ser mayor casi por definición, pero eso no significa que sea más variable en términos relativos.
3 · Requiere escala de razón
El CV es un cociente, y para que un cociente signifique algo el cero tiene que ser un cero real: ausencia de la magnitud.
Con temperatura en grados Celsius no funciona, porque el cero es convencional: el mismo conjunto de datos da coeficientes distintos si se lo mide en Celsius o en Kelvin. Con ingreso, peso, edad o tiempo sí funciona, porque el cero significa “nada”.
Y por la misma razón: si la media es cero o está cerca de cero, el CV se dispara y deja de tener sentido.
Eso no es un caso raro de laboratorio. Cualquier variable centrada lo cumple: un retorno financiero, la diferencia entre dos mediciones del mismo objeto, un puntaje estandarizado. Sobre los retornos diarios de 170 acciones del S&P 500 el CV recorre de 1.479 % a 12.487 % —el desvío llega a ser 125 veces la media— sin que eso signifique que la última sea ocho veces más variable que la primera: significa que su media quedó más cerca de cero. El caso Medir la dispersión cuando la media está en cero muestra qué se hace en esa situación, y por qué las alternativas tampoco son gratis.
4 · Un ejemplo
Con la EPH del primer trimestre de 2026:
| Variable | Media | Desvío | CV |
|---|---|---|---|
| Ingreso | $1.104.227 | $1.063.114 | 96,3 % |
| Edad | 41,0 años | 12,9 años | 31,4 % |
| Personas por hogar | 2,95 | 1,67 | 56,8 % |
La lectura es inmediata: el ingreso es, por lejos, la variable más heterogénea. Su desvío estándar es casi tan grande como su media.
La edad es la más homogénea: los ocupados se parecen bastante entre sí en edad, lo cual tiene sentido porque el mercado de trabajo recorta por abajo y por arriba.
Sin el CV, comparar “12,9 años” con “$1.063.114” sería imposible.
5 · Cómo se interpreta
No hay umbrales universales, pero sí referencias de uso común:
| CV | Lectura habitual |
|---|---|
| Menor a 15 % | Poca dispersión, grupo homogéneo |
| 15 % a 30 % | Dispersión moderada |
| Mayor a 30 % | Alta dispersión |
| Cerca o arriba de 100 % | El desvío iguala a la media; casi seguro hay asimetría fuerte |
Esos cortes son convenciones, no reglas, y cambian por disciplina: en mediciones de laboratorio un CV del 10 % ya es mucho, y en variables económicas un 60 % es normal.
6 · La versión robusta
Si el CV se descarta por asimetría, queda un hueco: la pregunta “¿cuál de estas dos variables es más dispersa?” sigue siendo válida. La respuesta es la misma idea con las medidas robustas: el coeficiente de variación cuartílico, que divide el rango intercuartílico por la mediana.
Para el ingreso da , y para la edad . Se lee igual que el CV clásico —el ingreso sigue siendo mucho más disperso— pero sin que la cola alta domine el resultado.
7 · El otro CV: el de una estimación
En los cuadros de los organismos estadísticos aparece una columna “CV” que no es esta medida, y confundirlas lleva a leer mal cualquier publicación oficial. Ese CV divide el error estándar de la estimación por la estimación misma:
No describe cuán dispersos están los datos, sino cuán precisa es la cifra publicada. Un CV del 3 % en una tasa de desocupación significa que, si se repitiera el muestreo, el valor se movería poco; uno del 35 %, que ese número apenas se sostiene.
| CV de la estimación | Criterio habitual de publicación |
|---|---|
| Hasta ~10 % | Se publica sin reservas |
| ~10 % a ~20 % | Se publica con advertencia de precisión |
| Más de ~20 % | No se publica, o se agrupa con otra categoría |
Los umbrales exactos varían entre organismos y entre operativos, pero la lógica es siempre esa: es el criterio por el cual una celda de una tabla aparece vacía, con un asterisco o agrupada. Cuando en un cuadro provincial falta el dato de una categoría chica, casi siempre es porque su CV superó el umbral, no porque nadie lo haya calculado.
8 · Errores frecuentes
- Usarlo con escalas de intervalo. Temperatura en Celsius, años calendario, puntajes estandarizados. El cero tiene que ser absoluto.
- Usarlo con medias cercanas a cero. El cociente explota y el resultado no significa nada. Le pasa a cualquier variable centrada —retornos, diferencias entre dos mediciones, puntajes—, y qué se hace en ese caso no tiene una respuesta cómoda.
- Usarlo con variables que toman valores negativos. El CV pierde sentido: la media puede estar cerca de cero por compensación.
- Tomar los umbrales como reglas. “CV mayor a 30 % es alta dispersión” es una orientación, no un criterio de decisión.
- Informarlo sin la media y el desvío. El CV resume, no reemplaza. Van los tres.
- Mezclar el CV clásico con el cuartílico. Son dos números distintos; hay que decir cuál se informa.
- Confundirlo con el CV de la estimación. En los informes de organismos estadísticos, el “CV” mide precisión del dato publicado y no dispersión de la variable. Son dos indicadores con el mismo nombre y usos opuestos.
9 · En el software
# R — no viene incorporado
cv <- function(x) sd(x, na.rm = TRUE) / mean(x, na.rm = TRUE)
100 * cv(datos$ingreso)

# Versión cuartílica
100 * IQR(datos$ingreso) / median(datos$ingreso)

# Con ponderadores. as.numeric() evita el NA por desborde de enteros
x <- as.numeric(datos$ingreso); w <- datos$ponderador
100 * sqrt(Hmisc::wtd.var(x, w)) / weighted.mean(x, w)
# Python
100 * datos["ingreso"].std() / datos["ingreso"].mean()
from scipy.stats import variation
variation(datos["ingreso"], ddof=1)
# Con ponderadores
import numpy as np
x, w = datos["ingreso"], datos["ponderador"]
m = np.average(x, weights=w)
100 * np.sqrt(np.average((x - m)**2, weights=w)) / mExcel: =DESVEST.M(rango) / PROMEDIO(rango)Herramientas de este tema
- CalculadoraDescriptivos desde datos pegados
Seguir leyendo
Bioestadística · Fundamentos y descripción · 41 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 40 de 318
Probabilidad y Estadística · Fundamentos y descripción · 41 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 37 de 288
Estadística para la tesis · Los datos · 87 de 233
Cómo citar: Montivero, J. L. (2026). Coeficiente de variación. estadistica.ar. https://estadistica.ar/conceptos/coeficiente-de-variacion
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Coeficiente de variación. estadistica.ar. https://estadistica.ar/conceptos/coeficiente-de-variacion
BibTeX
@misc{estadistica_ar_coeficiente_de_variacion,
  author       = {Montivero, Jorge Luis},
  title        = {{Coeficiente de variación}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/coeficiente-de-variacion}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.