estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/por-que-n-menos-1
Por qué se divide por n−1
La corrección de Bessel explicada sin demostración: por qué dividir por n subestima la varianza poblacional y cuándo corresponde cada denominador.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
Al calcular la varianza de una muestra se divide por en lugar de por . Esa corrección se llama corrección de Bessel, aunque Gauss ya la usaba en 1823, y el son los grados de libertad.
2 · El problema que resuelve
Cuando se calcula la varianza de una muestra, casi nunca se conoce la media poblacional : se usa la media muestral en su lugar.
Y acá está la clave: es, por construcción, el valor que minimiza la suma de cuadrados de esa muestra. Ningún otro número —incluida la verdadera — da una suma más chica.
Entonces la suma de cuadrados calculada alrededor de es sistemáticamente menor que la que se obtendría alrededor de . Dividir por arrastra ese defecto y subestima la varianza poblacional. Dividir por lo compensa exactamente, en promedio: en una muestra concreta el resultado puede quedar arriba o abajo, pero no se equivoca sistemáticamente para un lado.
En lenguaje técnico: con el estimador es insesgado, o sea que en promedio, sobre muchas muestras posibles, da el valor correcto.
La fórmula poblacional divide por y no por , y no es una inconsistencia. Con toda la población no se estima nada: la media calculada es , y la varianza que resulta es una descripción exacta, no una estimación que pueda equivocarse. La corrección existe porque se gastó la muestra en estimar la media.
3 · Qué son los grados de libertad
Otra forma de verlo, más intuitiva.
Los desvíos no son independientes entre sí: están atados por la restricción de que suman cero.
Conocidos de ellos, el último queda determinado: no tiene libertad de variar. Con diez datos hay diez desvíos, pero solo nueve piezas de información independientes.
Esa cantidad —cuántos valores pueden variar libremente— son los grados de libertad, y son el denominador correcto.
4 · Verlo funcionar
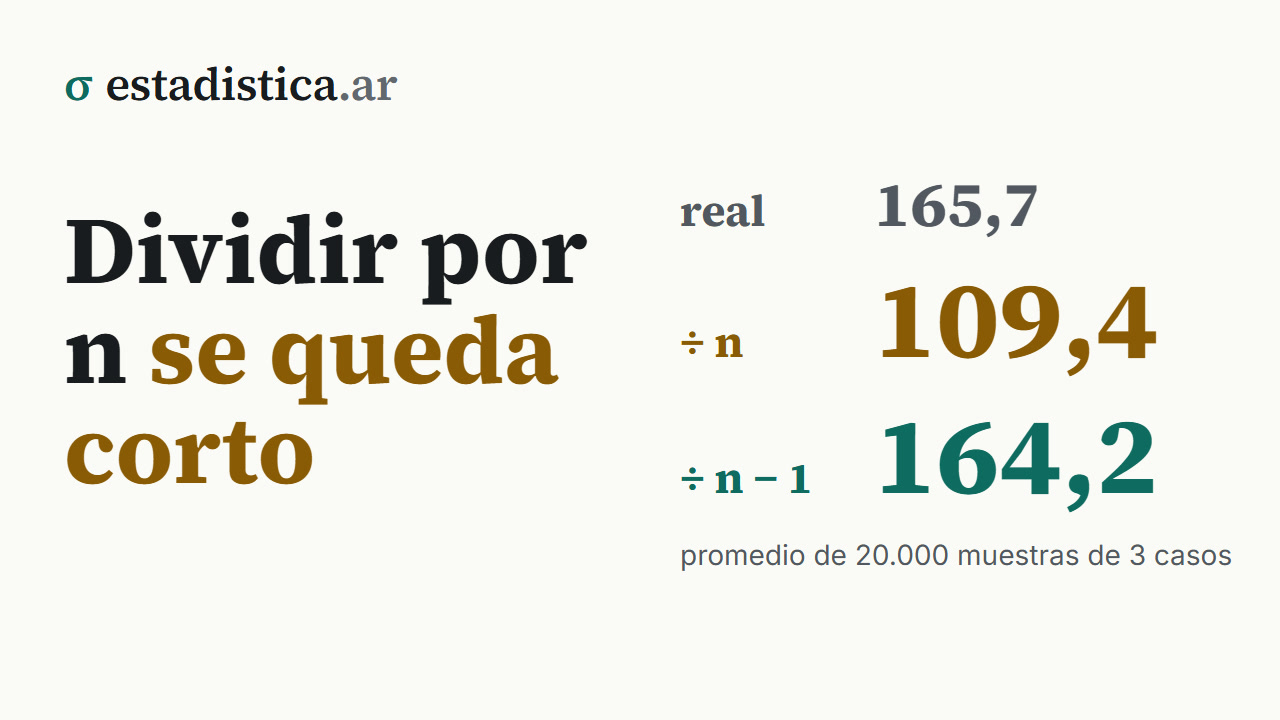
La afirmación “en promedio da el valor correcto” se puede comprobar. Tomando muchísimas muestras de una población conocida —una normal con varianza 100— y calculando las dos versiones en cada una, esto es lo que promedian:
| Dividiendo por | Dividiendo por | |
|---|---|---|
| 3 | 66,9 | 100,4 |
| 5 | 79,9 | 99,9 |
| 10 | 90,0 | 100,0 |
| 30 | 96,6 | 99,9 |
La columna del medio no se acerca al 100 por casualidad: se queda corta en exactamente la proporción — dos tercios con tres datos, el 80 % con cinco—. La columna de la derecha da 100 con cualquier tamaño de muestra. Eso es ser insesgado.
5 · Cuándo corresponde cada uno
| Situación | Denominador |
|---|---|
| Datos de una muestra, para estimar la población | |
| Datos de toda la población (censo completo) | |
| Describir solo el grupo observado, sin generalizar | |
| Encuesta con ponderadores | peso total |
En la práctica, casi siempre corresponde , porque casi siempre se trabaja con muestras. Por eso R, pandas y SPSS lo usan por defecto.
6 · Cuánto cambia
La corrección importa poco con muchos datos y mucho con pocos:
| Diferencia en el desvío | ||
|---|---|---|
| 5 | 1,250 | 11,8 % más grande |
| 10 | 1,111 | 5,4 % |
| 30 | 1,034 | 1,7 % |
| 100 | 1,010 | 0,5 % |
| 15.448 | 1,0001 | Despreciable |
Con la muestra de ocupados de la EPH la diferencia aparece recién en el sexto dígito. Con cinco mediciones de laboratorio, en cambio, cambia el resultado de manera perceptible.
Eso explica una paradoja aparente: el tema se enseña mucho y casi nunca cambia una conclusión. Lo que sí cambia es entender de dónde salen los grados de libertad, que reaparecen en todas las pruebas de hipótesis.
7 · La misma idea, en todo lo que viene después
La regla general es una sola: los grados de libertad son la cantidad de datos menos la cantidad de cantidades que se estimaron con esos mismos datos. La varianza gasta una en la media; los demás procedimientos gastan las suyas.
| Procedimiento | Grados de libertad | Qué se estimó |
|---|---|---|
| Varianza muestral | La media | |
| Prueba t de una muestra | La media | |
| Regresión simple | Pendiente y ordenada | |
| Regresión múltiple con predictores | Los coeficientes y la constante | |
| Chi-cuadrado en una tabla | Los totales marginales |
Ver grados de libertad para el desarrollo completo.
8 · Errores frecuentes
- Elegir mal la función en Excel.
DESVEST.Musa yDESVEST.Pusa ; lo mismoVAR.SyVAR.Ppara la varianza. El nombre no ayuda: la “M” es de muestra y la “P” de población. La que casi siempre corresponde es la M. - Mezclar NumPy con pandas.
np.std()usa y.std()de pandas usa . Dos números distintos para el mismo dato. - Usar cuando se tiene toda la población. Si censaste los 22 hospitales de la provincia y querés describir solo esos 22, el denominador es 22.
- Creer que “corrige el sesgo del desvío estándar”. Corrige el de la varianza. La raíz cuadrada de un estimador insesgado no es insesgada: el desvío calculado con sigue quedando corto, un 6 % con cinco datos.
- Pensar que el es exclusivo de la varianza. Es un caso particular de una regla general: se resta un grado por cada cantidad estimada.
- Discutirlo con muestras grandes. Con mayor a unos cien, la diferencia es irrelevante para cualquier conclusión.
9 · En el software
# R usa n−1 siempre, sin opción
var(x); sd(x)

# Para la versión poblacional hay que corregir a mano
var(x) * (length(x) - 1) / length(x)
# Python: el parámetro se llama ddof (delta degrees of freedom)
datos["x"].std() # pandas: ddof=1 → n−1
np.std(datos["x"]) # NumPy: ddof=0 → n
np.std(datos["x"], ddof=1) # NumPy con n−1
import statistics # biblioteca estándar
statistics.stdev(lista) # n−1
statistics.pstdev(lista) # nExcel: =DESVEST.M(rango) n−1 ← la habitual
=DESVEST.P(rango) n
=VAR.S(rango) n−1 la varianza, con la misma trampa
=VAR.P(rango) nSeguir leyendo
Bioestadística · Fundamentos y descripción · 40 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 39 de 318
Probabilidad y Estadística · Fundamentos y descripción · 40 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 36 de 288
Cómo citar: Montivero, J. L. (2026). Por qué se divide por n−1. estadistica.ar. https://estadistica.ar/conceptos/por-que-n-menos-1
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Por qué se divide por n−1. estadistica.ar. https://estadistica.ar/conceptos/por-que-n-menos-1
BibTeX
@misc{estadistica_ar_por_que_n_menos_1,
  author       = {Montivero, Jorge Luis},
  title        = {{Por qué se divide por n−1}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/por-que-n-menos-1}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.