estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/dispersion-en-variables-cualitativas
Dispersión en variables cualitativas
Cómo se mide si las respuestas están concentradas en una categoría o repartidas entre varias, cuando no hay números que restar.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · El problema
Todas las medidas de dispersión del módulo —rango, rango intercuartílico, desvío estándar, coeficiente de variación— necesitan restar valores. Con una variable nominal no se puede: “provincia de Salta menos provincia de Jujuy” no es nada.
Y sin embargo la pregunta existe y es muy concreta:
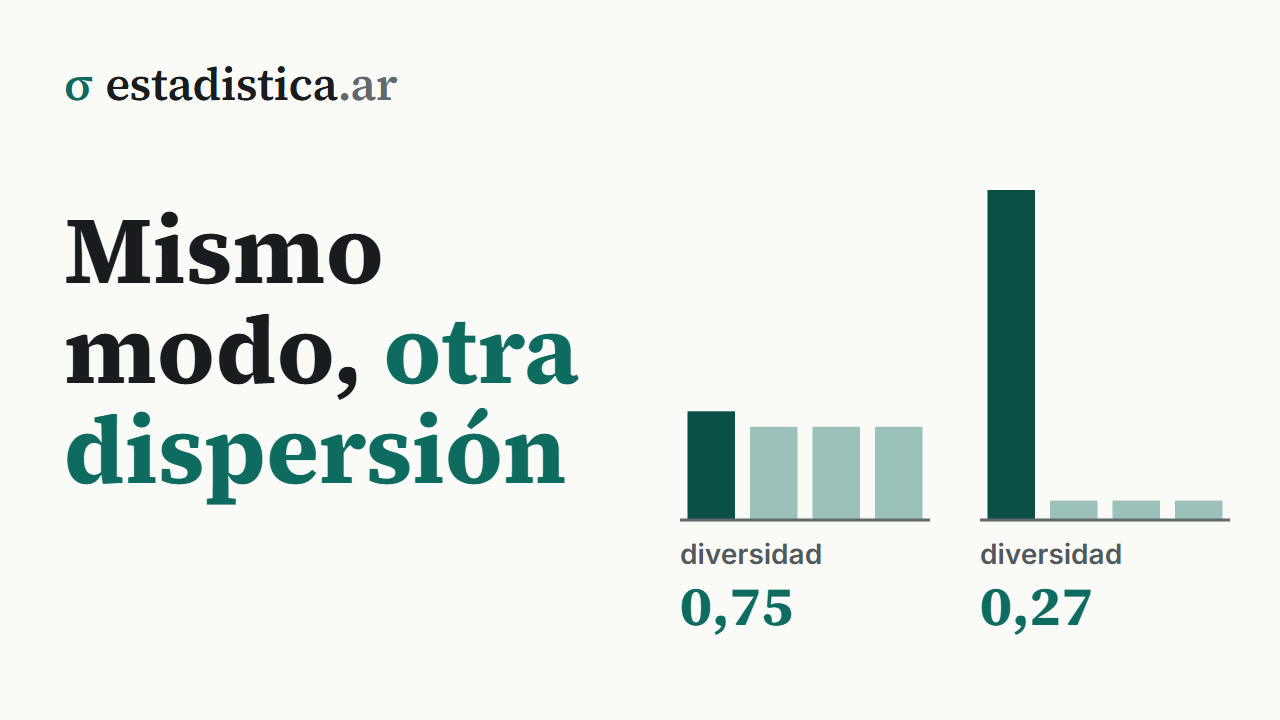
Una encuesta donde el 85 % contesta lo mismo y otra donde la categoría más frecuente llega al 30 % tienen el mismo tipo de resumen —el modo— y describen realidades opuestas. Esa diferencia es la dispersión de una cualitativa, y se mide.
2 · Qué significa “disperso” acá
No hay distancias, así que la dispersión no puede ser una distancia promedio. Lo que se mide es cuán repartidos están los casos entre las categorías disponibles, y tiene dos extremos claros:
| Situación | Cómo se ve | Dispersión |
|---|---|---|
| Todos los casos en una sola categoría | Una barra y el resto en cero | Mínima: cero |
| Los casos repartidos en partes iguales | Todas las barras iguales | Máxima |
Entre esos dos extremos se ubican todas las distribuciones reales, y las medidas que siguen son formas de poner un número a esa ubicación.
3 · Las cuatro medidas
Razón de variación. La más simple: qué proporción de los casos no está en la categoría modal.
Índice de diversidad. Uno menos la suma de los cuadrados de las proporciones:
Índice de variación cualitativa. El mismo índice, dividido por su máximo posible, para que vaya de 0 a 1 sin importar cuántas categorías haya:
Entropía. La medida que viene de la teoría de la información:
Su máximo es , así que se suele informar relativa: , también entre 0 y 1.
4 · Cómo se interpretan
Las cuatro dicen algo parecido y ninguna dice exactamente lo mismo:
| Medida | Qué significa su valor | Rango |
|---|---|---|
| Razón de variación | La proporción que quedó fuera de la categoría más frecuente | 0 a |
| Diversidad | La probabilidad de que dos casos al azar caigan en categorías distintas | 0 a |
| Variación cualitativa | Qué tan lejos está del reparto perfectamente parejo | 0 a 1 |
| Entropía relativa | Cuánta incertidumbre hay sobre la categoría de un caso cualquiera | 0 a 1 |
La suma tiene nombre propio en otras disciplinas. En economía es el índice de Herfindahl-Hirschman (HHI), con el que se mide la concentración de un mercado entre empresas: la diversidad es . En ecología, la diversidad se conoce como índice de Gini-Simpson. Y su inversa, , es el número efectivo de categorías: cuántas categorías igual de grandes darían la misma concentración. En ciencia política, aplicado a los votos, es el “número efectivo de partidos”.
La entropía dice algo sutilmente distinto: cuán difícil es adivinar la categoría de un caso. Vale cero cuando todos están en la misma —no hay nada que adivinar— y es máxima cuando están repartidos parejo. Es la misma idea que usa la compresión de archivos, y también la que está detrás de varios índices de segregación y de concentración económica.
5 · Un ejemplo con datos reales
El nivel educativo de las personas ocupadas de la EPH tiene siete categorías, con un modo del 31,3 % en secundario completo:
| Medida | Valor |
|---|---|
| Razón de variación | 0,687 |
| Índice de diversidad | 0,782 |
| Índice de variación cualitativa | 0,913 |
| Entropía relativa | 0,836 |
Se leen así: el 68,7 % de los ocupados está fuera de la categoría más frecuente; tomando dos personas al azar, hay un 78,2 % de probabilidad de que tengan distinto nivel educativo; y el reparto entre las siete categorías llega al 91 % del máximo posible. Es una variable muy poco concentrada: no hay un nivel educativo que domine. Su número efectivo de categorías es 4,6: las siete se comportan como casi cinco categorías iguales.
Los valores están calculados con el ponderador (PONDERA). Sin ponderar, la
diversidad da 0,776 y el IVC, 0,906.
Para ver qué significan esos números, tres distribuciones de cuatro categorías:
| Distribución | Modo | Diversidad | IVC |
|---|---|---|---|
| 25 · 25 · 25 · 25 | 25 % | 0,750 | 1,000 |
| 40 · 30 · 20 · 10 | 40 % | 0,700 | 0,933 |
| 85 · 5 · 5 · 5 | 85 % | 0,270 | 0,360 |
Las dos últimas filas son el caso que el modo no distingue: informar “la categoría más frecuente es la primera” vale para las dos, y solo el índice muestra que en una de ellas casi no hay nada más. (La primera fila ni siquiera tiene modo: las cuatro categorías empatan.)
6 · Cuál usar, y una trampa
Para un informe, la razón de variación casi siempre alcanza y se explica en una línea. El índice de diversidad es el que tiene la interpretación más linda. El IVC es el que hay que usar para comparar. Y la entropía es la que aparece en la literatura de segregación, ecología y teoría de la información.
7 · Errores frecuentes
- Calcular el desvío estándar de una variable nominal. El software lo hace si está codificada con números, y el resultado no significa nada.
- Comparar índices de diversidad entre variables con distinta cantidad de categorías. Hay que normalizar: IVC o entropía relativa.
- Informar solo el modo. No distingue una categoría que domina de una que apenas encabeza.
- Olvidar que el resultado depende de cómo se agrupó. Las mismas personas con siete categorías o con tres dan índices distintos. Agrupar siempre baja la diversidad y la entropía, pero las medidas normalizadas pueden subir: el nivel educativo en tres grupos da una diversidad de 0,659 (contra 0,782) y un IVC de 0,989 (contra 0,913).
- Usar la entropía con muchas categorías de frecuencia mínima. Con cincuenta categorías y la mitad con un caso, la entropía sube por el ruido de la cola. La diversidad casi no se mueve, porque el cuadrado de una proporción ínfima es todavía más ínfimo.
- Tratarlo como una medida de desigualdad. Mide reparto entre categorías, no desigualdad de una magnitud: para eso están el Gini y la curva de Lorenz.
8 · En el software
# R — a partir de la tabla de frecuencias
p <- prop.table(table(datos$nivel))
p <- prop.table(xtabs(PONDERA ~ nivel, datos))   # con el ponderador
p <- p[p > 0]     # sin categorías vacías: 0 * log(0) da NaN
k <- length(p)

rv  <- 1 - max(p)
d   <- 1 - sum(p^2)
ivc <- k / (k - 1) * d
h   <- -sum(p * log(p))
h / log(k)        # entropía relativa
1 / sum(p^2)      # número efectivo de categorías
# Python
p = datos["nivel"].value_counts(normalize=True)
p = datos.groupby("nivel")["PONDERA"].sum() # con el ponderador
p = p[p > 0] / p.sum()
k = len(p)
rv = 1 - p.max()
d = 1 - (p**2).sum()
ivc = k / (k - 1) * d
h = -(p * np.log(p)).sum()
h / np.log(k)
1 / (p**2).sum() # número efectivoExcel: con las proporciones en B2:B8
=1 - MAX(B2:B8) razón de variación
=1 - SUMAPRODUCTO(B2:B8; B2:B8) diversidad
=CONTARA(B2:B8)/(CONTARA(B2:B8)-1) * (1 - SUMAPRODUCTO(B2:B8;B2:B8))
=-SUMAPRODUCTO(B2:B8; LN(B2:B8)) / LN(CONTARA(B2:B8))
entropía relativa (falla
si alguna proporción es 0)Seguir leyendo
Bioestadística · Fundamentos y descripción · 42 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 41 de 318
Probabilidad y Estadística · Fundamentos y descripción · 42 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 38 de 288
Estadística para la tesis · Los datos · 88 de 233
Cómo citar: Montivero, J. L. (2026). Dispersión en variables cualitativas. estadistica.ar. https://estadistica.ar/conceptos/dispersion-en-variables-cualitativas
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Dispersión en variables cualitativas. estadistica.ar. https://estadistica.ar/conceptos/dispersion-en-variables-cualitativas
BibTeX
@misc{estadistica_ar_dispersion_en_variables_cualitativas,
  author       = {Montivero, Jorge Luis},
  title        = {{Dispersión en variables cualitativas}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/dispersion-en-variables-cualitativas}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.