estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/muestreo-probabilistico-y-no-probabilistico
Muestreo probabilístico y no probabilístico
La división que decide si se puede generalizar: qué significa que cada unidad tenga probabilidad conocida de ser elegida, y qué se pierde cuando no la tiene.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
En un muestreo probabilístico, cada unidad de la población tiene una probabilidad conocida y mayor que cero de ser seleccionada, y la selección la hace un mecanismo aleatorio.
En un muestreo no probabilístico esa probabilidad no se conoce, o algunas unidades directamente no pueden entrar.
2 · Qué habilita el probabilístico
Tres cosas, y ninguna está disponible sin él:
Estimar sin sesgo de selección. El mecanismo aleatorio garantiza que, en promedio sobre todas las muestras posibles, el estimador apunta al valor verdadero.
Calcular el error. Como se conocen las probabilidades de selección, se puede calcular cuánto varía el resultado de muestra en muestra. De ahí salen el error estándar, el margen de error y los intervalos de confianza.
Generalizar formalmente. Toda la inferencia estadística supone muestreo probabilístico. Sin él, el p-valor y el intervalo de confianza no significan lo que dicen significar.
3 · Los tipos
Probabilísticos
| Diseño | Cómo selecciona |
|---|---|
| Aleatorio simple | Sorteo directo entre todas las unidades |
| Sistemático | Un arranque al azar y después cada k-ésimo |
| Estratificado | Se divide en grupos y se sortea dentro de cada uno |
| Por conglomerados | Se sortean grupos enteros |
No probabilísticos
| Diseño | Cómo selecciona |
|---|---|
| Por conveniencia | Los que están a mano |
| Por cuotas | Se completan cupos por categoría |
| Bola de nieve | Cada participante recluta al siguiente |
| Intencional (por juicio) | El investigador elige casos “típicos” |
4 · Qué se puede decir con cada uno
| Probabilístico | No probabilístico | |
|---|---|---|
| Describir la muestra | Sí | Sí |
| Calcular error muestral | Sí | No |
| Intervalo de confianza | Sí | No corresponde |
| Prueba de hipótesis | Sí | Formalmente, no |
| Generalizar a la población | Sí | No por inferencia estadística |
5 · Más datos, peor intervalo
Hay una intuición muy extendida: que un sesgo de selección chico se compensa con muchos casos. Pasa exactamente lo contrario, y se puede calcular.
Primero, una imagen. Una balanza que marca siempre 200 gramos de más tiene un error fijo: pesar la misma bolsa mil veces y promediar da un número muy estable, pero estable alrededor del valor equivocado. Más mediciones no corrigen la balanza; solo hacen que uno confíe más en ella.
Con una muestra mal seleccionada pasa lo mismo. El intervalo de confianza tiene un centro —la estimación— y un ancho —el margen de error—. Al crecer el ancho se achica, porque el azar pesa cada vez menos. Pero el sesgo de selección no es azar: no se achica con , y el centro del intervalo sigue corrido de la verdad en la misma medida. Mientras el intervalo es ancho, el corrimiento queda tapado y el valor verdadero cae adentro igual. Cuando el intervalo se vuelve más angosto que el corrimiento, el valor verdadero queda afuera.
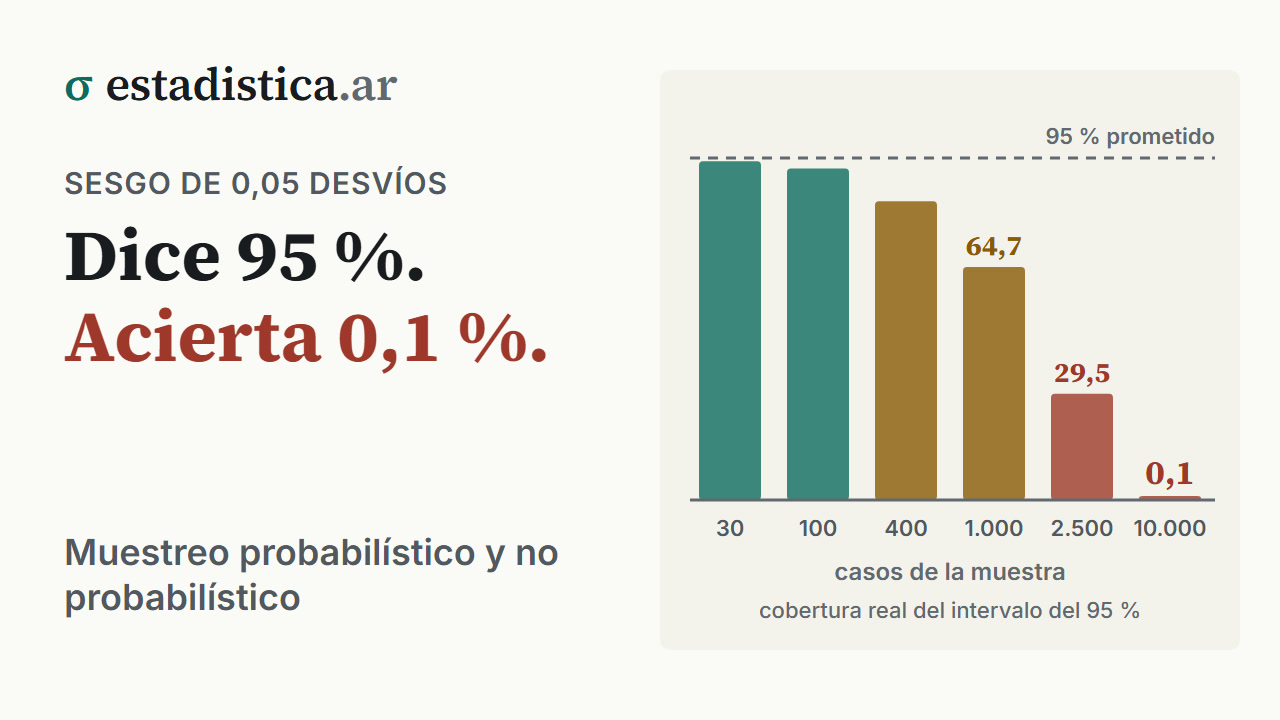
Supongamos un sesgo modesto y fijo de 0,05 desvíos —la estimación sale, en promedio, corrida un vigésimo de desvío estándar, la clase de corrimiento que produce cualquier selección imperfecta—. La tabla muestra, para cada tamaño, el ancho del intervalo del 95 % y su cobertura real: de cada 100 muestras de ese tamaño, en cuántas el intervalo contiene efectivamente al valor verdadero. Sin sesgo, esa cobertura sería 95 % en todas las filas.
| Ancho del intervalo | Cobertura real | |
|---|---|---|
| 30 | ± 0,358 | 94,1 % |
| 100 | ± 0,196 | 92,1 % |
| 400 | ± 0,098 | 83,0 % |
| 1.000 | ± 0,062 | 64,7 % |
| 2.500 | ± 0,039 | 29,5 % |
| 10.000 | ± 0,020 | 0,1 % |
El punto de quiebre está donde el margen del intervalo se iguala al sesgo: con 0,05 desvíos ocurre alrededor de los 1.500 casos, y ahí el intervalo ya falla en la mitad de las muestras. Con un sesgo de 0,20 desvíos el derrumbe llega antes: 48 % de cobertura con 100 casos y 2 % con 400.
6 · Por qué las cuotas no arreglan el problema
El muestreo por cuotas suele presentarse como el sustituto barato del probabilístico: si la muestra tiene la misma composición por sexo y edad que la población, parecería representativa.
Se puede poner a prueba. Población simulada de 500.000 personas, donde la variable de interés depende del sexo, de la edad y de una tercera característica —del tipo “usa internet a diario”—, y donde responder depende sobre todo de :
| Estimación | Sesgo | |
|---|---|---|
| Valor verdadero | 0,4173 | — |
| Media simple de quienes responden | 0,4874 | +0,0701 |
| Corregida con cuotas por sexo × edad | 0,4876 | +0,0703 |
| Muestreo aleatorio simple del mismo tamaño | 0,4155 | −0,0018 |
7 · Cuándo el no probabilístico es la opción correcta
No es una versión defectuosa del otro: es la herramienta adecuada en varias situaciones.
- Estudios exploratorios, donde el objetivo es generar hipótesis.
- Poblaciones sin marco: no hay lista de personas en situación de calle ni de quienes trabajan de manera informal.
- Poblaciones ocultas o de difícil acceso, donde la bola de nieve es lo único que funciona.
- Investigación cualitativa, donde el criterio de selección es la riqueza del caso y no la representatividad.
- Pruebas piloto.
Lo que hay que hacer es declararlo y acotar las conclusiones: describir los casos estudiados, y no escribir como si fueran una muestra de algo más grande.
8 · La prueba de la realidad
En una tesis de grado, el muestreo no probabilístico es muy frecuente y muchas veces inevitable. La diferencia entre un trabajo sólido y uno débil no es cuál se usó, sino qué se escribió después.
| Muestreo | Redacción correcta |
|---|---|
| Probabilístico | “El 31,3 % de la población ocupada…” |
| No probabilístico | “El 31,3 % de los 120 casos relevados…” |
9 · Errores frecuentes
- Llamar aleatoria a una muestra por conveniencia. “Se seleccionaron al azar los pacientes que asistieron ese día” no es aleatorio: es por conveniencia con otro nombre.
- Calcular márgenes de error sobre muestras no probabilísticas. El número sale y no significa nada.
- Creer que el tamaño compensa. Es la confusión central: una muestra grande mal seleccionada sigue estando sesgada, solo que con más precisión. Con un sesgo de 0,05 desvíos y 10.000 casos, el intervalo del 95 % cubre el 0,1 %.
- Usar cuotas y presentarlo como probabilístico. Las cuotas controlan la composición, no la probabilidad de selección, y solo en las variables que uno eligió: en la simulación de la sección 6 el sesgo pasó de 0,0701 a 0,0703.
- No declarar el tipo de muestreo. Sin eso, el lector no puede evaluar nada.
- Hacer pruebas de hipótesis y no aclarar la limitación. Si se hacen igual —cosa que pasa y a veces se acepta—, va declarado como limitación.
Herramientas de este tema
- CalculadoraSelección de la muestra
Seguir leyendo
Bioestadística · De la muestra a la población · 141 de 330
Estadística para Economía y Administración · De la muestra a la población · 147 de 318
Probabilidad y Estadística · De la muestra a la población · 126 de 302
Estadística para Ciencias Sociales · De la muestra a la población · 120 de 288
Estadística para la tesis · La muestra · 46 de 233
Cómo citar: Montivero, J. L. (2026). Muestreo probabilístico y no probabilístico. estadistica.ar. https://estadistica.ar/conceptos/muestreo-probabilistico-y-no-probabilistico
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Muestreo probabilístico y no probabilístico. estadistica.ar. https://estadistica.ar/conceptos/muestreo-probabilistico-y-no-probabilistico
BibTeX
@misc{estadistica_ar_muestreo_probabilistico_y_no_probabilistico,
  author       = {Montivero, Jorge Luis},
  title        = {{Muestreo probabilístico y no probabilístico}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/muestreo-probabilistico-y-no-probabilistico}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-10-28}
}
Última actualización: 28 de octubre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.