estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/por-que-muestrear
Por qué se estudia una muestra
Las razones para observar una parte en vez del todo, y por qué una muestra bien elegida puede ser más precisa que un censo mal hecho.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
Muestrear es elegir, con un procedimiento definido de antemano, una parte de la población —la muestra—, observar solo esa parte y usar lo observado para sacar conclusiones sobre el total.
La definición tiene tres piezas y las tres importan. Hay una población a la que se quieren referir las conclusiones. Hay un procedimiento de selección que decide qué unidades entran, y de él depende que la parte se parezca al todo. Y hay un salto de la parte al todo, la inferencia, que nunca es exacto pero cuyo error se puede acotar.
La desocupación que el INDEC publica cada trimestre es el ejemplo más conocido: no sale de preguntarle a todos los habitantes, sino de la Encuesta Permanente de Hogares, que entrevista una muestra de hogares y desde ahí estima la tasa para el conjunto de la población urbana.
2 · Las cuatro razones
Costo. Un censo nacional cuesta miles de veces más que una encuesta. Con el mismo presupuesto se puede relevar una muestra todos los trimestres o un censo cada diez años.
Tiempo. Los datos de la EPH salen semanas después del trimestre; los de un censo, años después del operativo. Para decisiones que no pueden esperar, la muestra es la única opción.
Viabilidad. Hay poblaciones que no se pueden censar: el control de calidad por muestreo destructivo —probar la resistencia de un material hasta romperlo— no puede aplicarse a toda la producción, porque no quedaría nada para vender.
Calidad. La razón menos obvia y la más interesante: una muestra puede dar un resultado más exacto que un censo. Suena a paradoja, y por eso se desarrolla aparte en la sección siguiente.
3 · Por qué una muestra puede ser mejor que un censo
Con menos unidades que relevar se puede invertir más en cada una: encuestadores mejor capacitados, más visitas de reintento, mejor supervisión, control de consistencia más cuidadoso.
Un censo tiene que llegar a todos con los recursos que hay, y eso implica más personal menos entrenado, menos reintentos y más error no muestral.
El error de un relevamiento tiene dos fuentes. El error muestral aparece porque se observó una parte y no el todo; el error no muestral reúne todo lo demás: personas que no se encontraron, preguntas mal entendidas, respuestas mal anotadas, errores de carga. El censo elimina el primero, porque observa a todos, pero justamente por su escala está más expuesto al segundo.
Por eso los organismos estadísticos usan las dos herramientas: el censo para tener el marco y la desagregación fina, y las encuestas para el seguimiento frecuente y de calidad.
4 · Censo vs. muestra
| Censo | Muestra | |
|---|---|---|
| Cobertura | Toda la población | Una parte |
| Error muestral | No tiene | Sí, y se puede calcular |
| Error no muestral | Suele ser mayor | Suele ser menor |
| Desagregación | Máxima | Limitada por el diseño |
| Frecuencia | Baja | Alta |
| Costo | Muy alto | Medio |
La fila que define todo es la segunda: el error muestral existe y se conoce. Se puede informar como margen de error, se puede achicar aumentando el tamaño, y se puede tener en cuenta al interpretar.
Un error que se puede medir es infinitamente preferible a uno que no.
5 · Cuándo no conviene muestrear
Cuando la población es chica y accesible. Si son 22 hospitales o 140 docentes, se releva todo. La razón es la corrección por población finita: cuando la muestra es una fracción grande del total, los últimos casos son baratísimos en términos de precisión ganada. Con :
| Casos relevados | Error estándar | Casos que se ahorran |
|---|---|---|
| 70 | 0,085 · | 70 |
| 100 | 0,054 · | 40 |
| 120 | 0,035 · | 20 |
| 140 | 0 | 0 |
Pasar de 120 a 140 cuesta veinte entrevistas y elimina el error muestral por completo. No hay diseño que compita con eso.
Cuando hace falta desagregación fina. Una muestra diseñada para el total del país no da estimaciones confiables para un departamento chico.
Cuando se buscan casos raros. Para algo que afecta a 1 de cada 10.000:
| Tamaño de muestra | Casos esperados | P(no aparezca ninguno) |
|---|---|---|
| 1.000 | 0,10 | 90,5 % |
| 5.000 | 0,50 | 60,7 % |
| 10.000 | 1,00 | 36,8 % |
Con mil casos —una encuesta nacional respetable— lo más probable por lejos es no encontrar un solo caso. Para esperar diez hacen falta cien mil entrevistas, y ahí ya conviene un registro administrativo o un diseño que busque a propósito la población afectada.
Cuando el dato individual importa. Un padrón electoral o un registro de propiedad tienen que estar completos: no se muestrea lo que se necesita caso por caso.
6 · La condición
Todo lo anterior vale solo si la muestra permite generalizar, y para eso hacen falta dos cosas que cumplen funciones distintas:
- El mecanismo de selección decide si la muestra apunta al lugar correcto. Si los casos se eligieron al azar, el resultado no tiene sesgo de selección; si se eligieron por comodidad o se ofrecieron solos, puede estar desviado, y ningún tamaño lo corrige.
- El tamaño decide cuán cerca de ese lugar cae el resultado. Una muestra bien elegida pero chica es válida y poco precisa: con 30 casos se puede inferir, pero con un margen de error tan ancho que la conclusión dice poco.
El tamaño, además, no se elige a ojo: se calcula a partir de la precisión que se necesita. Como ese cálculo usa el margen de error de los intervalos de confianza, se desarrolla al final del módulo de Estimación: para una media, para una proporción y con población finita.
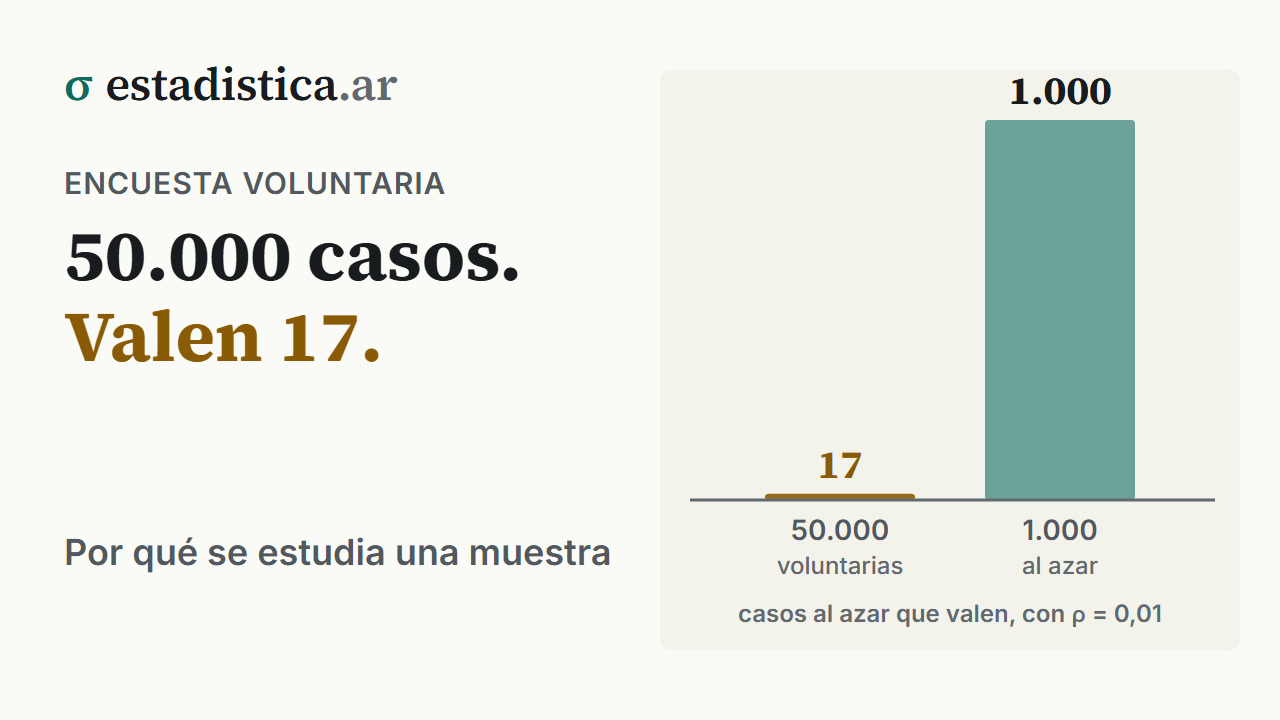
El orden de las dos importa, porque fallan de manera distinta. La falta de tamaño se ve —el margen de error sale ancho y avisa—; la falta de mecanismo no se ve. Una encuesta voluntaria por internet con 50.000 respuestas no permite concluir sobre la población general; una muestra probabilística de 1.000, sí. La diferencia está en el muestreo probabilístico, y la sección siguiente la pone en números.
7 · Cuánto vale realmente una muestra autoseleccionada
La afirmación anterior suena a prejuicio de estadístico. Se puede calcular.
Si quien responde se autoselecciona, el error del promedio no depende del tamaño de la manera habitual, sino de cuánta relación hay entre responder y la variable que se mide. Llamando a esa correlación y a la fracción relevada:
Igualando ese error al de una muestra aleatoria se obtiene a cuántos casos bien elegidos equivale:
Con una población de 30 millones y 50.000 respuestas voluntarias:
| Correlación entre responder y el dato | Equivale a un muestreo aleatorio de |
|---|---|
| 0,05 | 0,7 casos |
| 0,02 | 4,2 casos |
| 0,01 | 16,7 casos |
| 0,005 | 66,8 casos |
| 0,001 | 1.669 casos |
8 · Errores frecuentes
- Creer que muestrear es “conformarse con menos”. Con buen diseño, la pérdida de precisión es chica y calculable.
- Pensar que el tamaño determina la calidad. Determina la precisión; la validez la determina el mecanismo de selección.
- Confiar en una encuesta voluntaria porque tiene muchos casos. Con una correlación de 0,01 entre responder y el dato, 50.000 respuestas valen 17 casos al azar.
- Muestrear una población chica. Si son 40 casos y se pueden relevar todos, se relevan todos.
- Pedirle a la muestra desagregación que el diseño no contempla. Cuantos menos casos quedan en una celda, más grande es su error.
- Creer que el censo es exacto. Tiene omisión, error de declaración y error de procesamiento, y ninguno se puede calcular con una fórmula como el error muestral.
Herramientas de este tema
- CalculadoraTamaño de muestra
Seguir leyendo
Bioestadística · De la muestra a la población · 139 de 330
Estadística para Economía y Administración · De la muestra a la población · 145 de 318
Probabilidad y Estadística · De la muestra a la población · 124 de 302
Estadística para Ciencias Sociales · De la muestra a la población · 118 de 288
Estadística para la tesis · La muestra · 44 de 233
Cómo citar: Montivero, J. L. (2026). Por qué se estudia una muestra. estadistica.ar. https://estadistica.ar/conceptos/por-que-muestrear
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Por qué se estudia una muestra. estadistica.ar. https://estadistica.ar/conceptos/por-que-muestrear
BibTeX
@misc{estadistica_ar_por_que_muestrear,
  author       = {Montivero, Jorge Luis},
  title        = {{Por qué se estudia una muestra}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/por-que-muestrear}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-10-27}
}
Última actualización: 27 de octubre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.