estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/error-y-sesgo
Error y sesgo
La diferencia entre equivocarse al azar y equivocarse siempre para el mismo lado, y por qué aumentar la muestra arregla una cosa y no la otra.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
El error es la diferencia entre el valor observado y el valor verdadero. El sesgo es la parte de ese error que se repite siempre en la misma dirección.
Todo error se puede pensar partido en dos:
El sesgo es la parte que empuja siempre para el mismo lado; el azar, la que unas veces va para un lado y otras para el otro. La parte aleatoria tiene una propiedad que la vuelve manejable: promedia a cero. Si se repitiera el estudio muchas veces, esos desvíos se cancelarían entre sí. La parte sistemática no se cancela: está en todas las repeticiones, con el mismo signo, y por eso sobrevive a cualquier promedio.
2 · Para qué sirve la distinción
Conviene distinguirlos porque se corrigen de maneras opuestas.
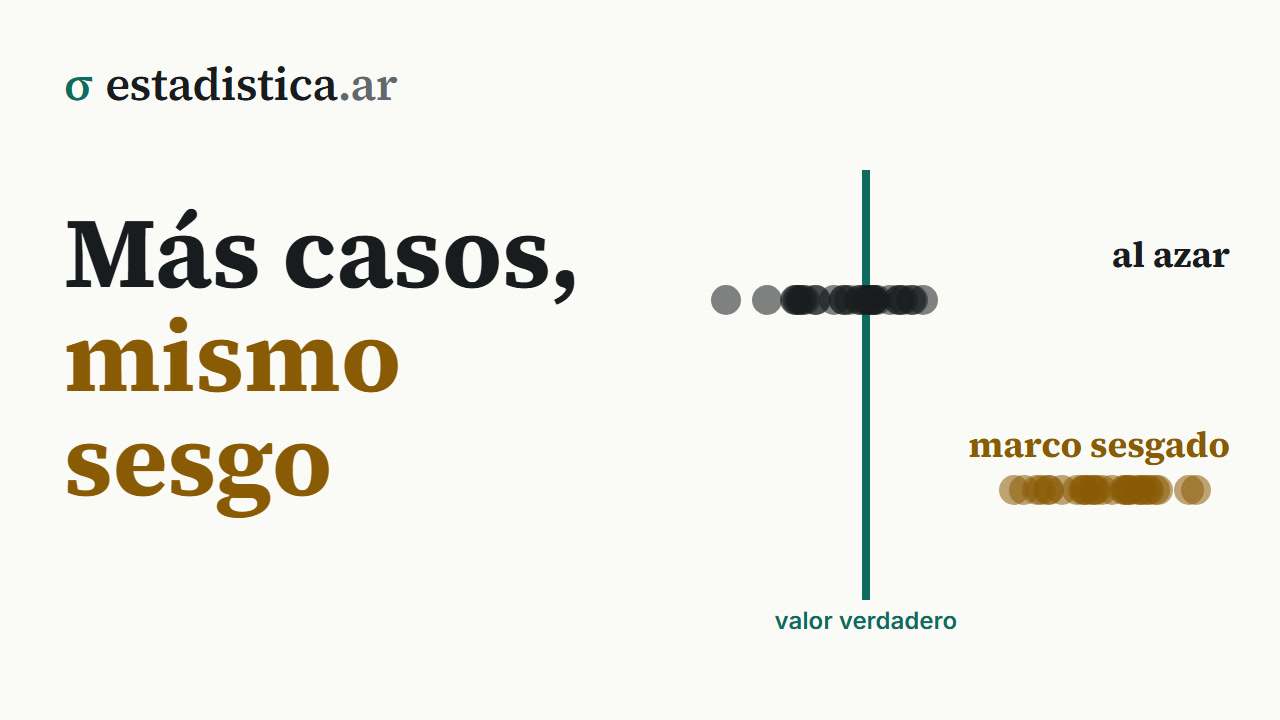
El error aleatorio se achica aumentando la muestra: cuantos más casos, menos se mueve el resultado de muestra en muestra. El sesgo no: si el instrumento está mal calibrado o el universo está mal cubierto, relevar diez veces más casos da un resultado igual de equivocado, con más precisión aparente.
3 · La analogía del tiro al blanco
Con el centro como valor verdadero y cada disparo como una medición:
- Sin sesgo y poco error: los tiros se agrupan alrededor del centro. Es el ideal.
- Sin sesgo y mucho error: los tiros se dispersan, pero el promedio da en el centro. Molesto, pero honesto: con más disparos mejora.
- Con sesgo y poco error: los tiros se agrupan muy juntos, lejos del centro. Es el peor caso, porque la consistencia se confunde con exactitud.
- Con sesgo y mucho error: desastre. Lo que se ve es la dispersión; el sesgo, igual que en el caso anterior, no se nota sin conocer el centro.
El tercero es el peligroso. Un resultado sesgado y preciso se ve profesional.
Ahí está la diferencia entre las dos palabras que se usan como sinónimos y no lo son: la precisión es cuán juntos caen los tiros entre sí —y se mide con los datos que uno tiene—; la exactitud es cuán cerca caen del centro, y para saberlo haría falta conocer el centro. Por eso el sesgo casi nunca se descubre mirando los propios datos: se descubre pensando cómo se produjeron, o comparándolos con otra fuente.
4 · Los tipos de error
Error muestral. Existe porque se observó una parte y no el todo. Es inevitable, se puede calcular y se informa como error estándar o margen de error. No es una falla: es la consecuencia medible de muestrear.
Error no muestral. Todo lo demás, y en general es más grande que el muestral:
- De cobertura: el marco no coincide con la población. Quedan afuera los que no tienen teléfono, los que no están en el padrón; o sobran unidades, como los duplicados o los que ya no pertenecen a la población.
- De no respuesta: quienes no contestan suelen diferir de quienes sí.
- De medición: la pregunta se entiende mal, el instrumento está descalibrado, la gente redondea o declara de menos.
- De procesamiento: errores de carga, de codificación, de programación.
Un censo no tiene error muestral, pero tiene todos los demás.
El peso de la no respuesta, en particular, se puede escribir con una fórmula simple. Si responde una fracción de los seleccionados, el sesgo de una media es aproximadamente
Las dos piezas importan. Con una tasa de respuesta del 90 %, una diferencia grande entre quienes contestan y quienes no igual produce sesgo; con una del 50 %, si los dos grupos se parecen, el sesgo puede ser chico. Por eso la tasa de respuesta sola no alcanza para juzgar una encuesta, pero sin ella no se puede empezar.
5 · Cómo se previene y cómo se mide cada uno
Cada fuente de error se ataca en un momento distinto, y casi todas antes de tener los datos:
| Fuente | Cómo se previene | Cómo se evalúa después |
|---|---|---|
| Muestral | Con el tamaño y el diseño de la muestra | Se calcula: error estándar, margen de error |
| De cobertura | Mejorando el marco muestral | Comparando el marco con una fuente externa |
| De no respuesta | Reintentos, incentivos; después, ajuste por ponderación | Tasa de respuesta y perfil de quienes faltan |
| De medición | Prueba piloto del cuestionario, capacitación | Repreguntas de control, remedición de una submuestra |
| De procesamiento | Validaciones de carga, doble entrada | Recontrol de una muestra de formularios |
Cuando un sesgo no se puede eliminar —y muchas veces no se puede—, queda algo que sí siempre se puede hacer: declarar su dirección. Decir “los ingresos altos se subdeclaran, así que la desigualdad medida es un piso y no un techo” convierte un defecto oculto en un dato interpretable, y le da al lector lo que necesita para leer el número como corresponde.
6 · Los dos sentidos de «sesgo»
Conviene separarlos porque se estudian en momentos distintos de la materia y se arreglan de maneras distintas:
- El sesgo del dato. Los datos se produjeron torcidos: el marco dejaba gente afuera, la balanza pesaba de más, la pregunta inducía la respuesta. Es el de esta entrada, y se arregla en el diseño; ver sesgos en investigación.
- El sesgo del estimador. Los datos están perfectos pero la fórmula con la que se los resume apunta sistemáticamente al lado equivocado. El ejemplo canónico es la varianza: dividir por en vez de por subestima la varianza poblacional en promedio —en una muestra concreta puede caer arriba o abajo, pero repetida muchas veces queda corta—, y por eso existe la corrección.
El segundo tiene una forma precisa. Un estimador es insesgado si su valor esperado es el parámetro, , y su error total se mide con el error cuadrático medio, que vuelve a partirse en las mismas dos piezas:
7 · Un ejemplo
En la EPH, los ingresos declarados tienen un patrón conocido: la gente responde en números redondos y los ingresos altos tienden a subdeclararse. En el extracto de ocupados del primer trimestre de 2026, el 77 % de los ingresos son múltiplos de $100.000, el valor más frecuente es exactamente $1.000.000 (1.191 casos) y cinco montos redondos concentran casi un tercio de las respuestas.
Lo primero es error de medición sin sesgo claro: los redondeos van para arriba y para abajo y se compensan bastante. Lo segundo es sesgo: si los ingresos altos se declaran sistemáticamente por debajo, el ingreso medio estimado queda por debajo del real, y ninguna cantidad de casos lo corrige.
Es también un caso donde la dirección se conoce: se sabe que el sesgo va hacia abajo y que golpea más al promedio que a la mediana, porque lo que se pierde está en la cola alta. Eso alcanza para leer con cuidado la comparación entre las dos medidas, aunque no alcance para corregir el dato.
Por eso los organismos estadísticos dedican tanto trabajo a la no respuesta y a la subdeclaración, y tan poco, comparativamente, a agrandar la muestra.
8 · Errores frecuentes
- Creer que más casos arreglan todo. Es la confusión central de este tema. Una encuesta voluntaria por internet con 100.000 respuestas está tan sesgada como con 1.000, y es más fácil creerle. Meng lo cuantificó con las encuestas de la elección estadounidense de 2016: 2,3 millones de respuestas autoseleccionadas, con un sesgo de selección mínimo, equivalían en error a una muestra al azar de unas 400 personas. La cuenta completa está en big data.
- Informar solo el error muestral. Es el único que se puede calcular, así que es el único que aparece en los informes — y suele ser el más chico. El margen de error publicado no incluye la no respuesta ni la mala medición.
- Confundir precisión con exactitud. Precisión es que las mediciones se parezcan entre sí; exactitud es que den cerca del valor verdadero. Se puede ser muy preciso y estar muy equivocado.
- Buscar el sesgo dentro de los datos. Los datos sesgados se ven perfectos: son coherentes, tienen poca dispersión y pasan todos los controles. El sesgo se detecta pensando cómo se produjo el dato o comparándolo con otra fuente.
- Tratar el error como sinónimo de equivocación. El error muestral no es una falla de nadie: es la consecuencia esperable y cuantificada de observar una parte.
- No declarar la dirección del sesgo que se conoce. Si se sabe que la cifra está subestimada, decirlo cuesta una oración y cambia por completo cómo se lee el resultado.
- No declarar la tasa de respuesta. Es el indicador que permite al lector juzgar el riesgo de sesgo. Omitirla no lo hace desaparecer.
Referencias
- Squire, P. (1988). Why the 1936 Literary Digest poll failed. Public Opinion Quarterly, 52(1), 125–133. https://doi.org/10.1086/269085
- Lohr, S. L., & Brick, J. M. (2017). Roosevelt predicted to win: Revisiting the 1936 Literary Digest poll. Statistics, Politics and Policy, 8(1), 65–84. https://doi.org/10.1515/spp-2016-0006
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-AOAS1161SF
Todas las obras que cita el sitio están en la bibliografía.
Seguir leyendo
Bioestadística · Fundamentos y descripción · 14 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 14 de 318
Probabilidad y Estadística · Fundamentos y descripción · 14 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 14 de 288
Estadística para la tesis · Diseño del estudio · 22 de 233
Cómo citar: Montivero, J. L. (2026). Error y sesgo. estadistica.ar. https://estadistica.ar/conceptos/error-y-sesgo
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Error y sesgo. estadistica.ar. https://estadistica.ar/conceptos/error-y-sesgo
BibTeX
@misc{estadistica_ar_error_y_sesgo,
  author       = {Montivero, Jorge Luis},
  title        = {{Error y sesgo}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/error-y-sesgo}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.