estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/distribucion-de-frecuencias
Distribución de frecuencias
Qué es una distribución de frecuencias, para qué sirve y cómo se leen las frecuencias absolutas, relativas y porcentuales de una variable.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
Una distribución de frecuencias es la organización de un conjunto de datos que muestra qué valores toma una variable y cuántas veces aparece cada uno.
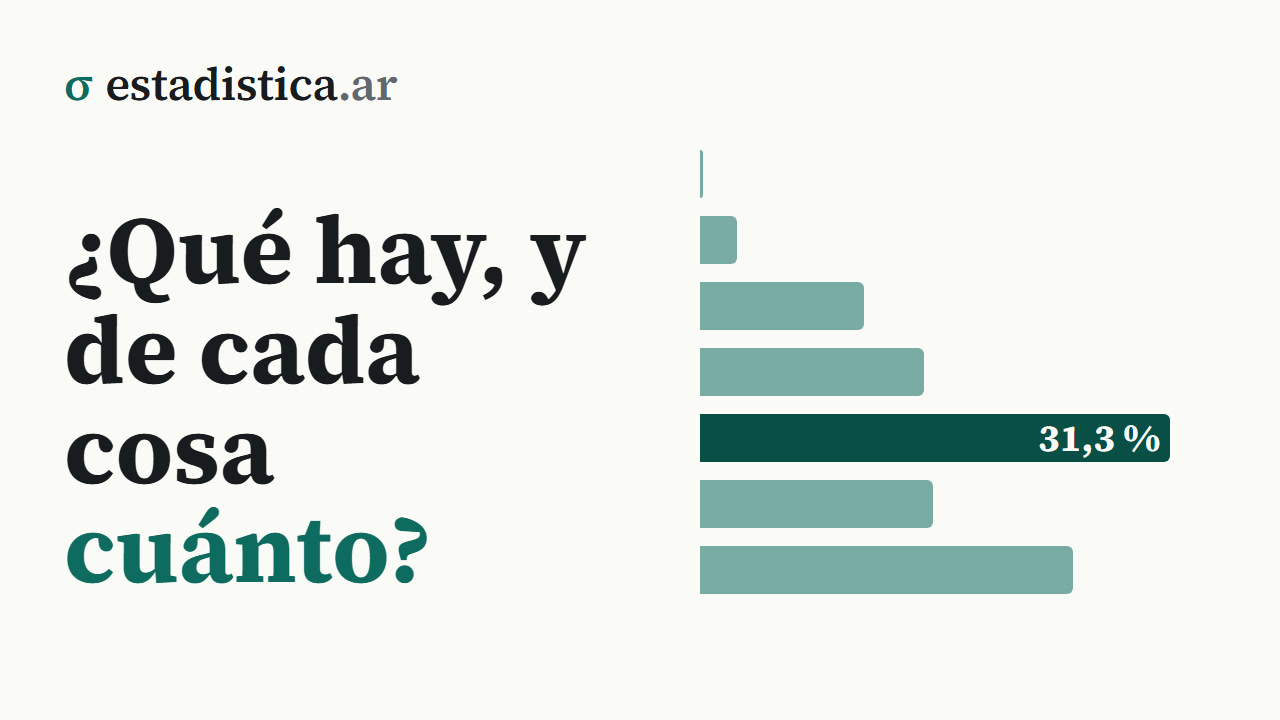
Conviene separar dos cosas que se nombran igual. La distribución es el reparto en sí: el hecho de que los casos se acumulen en ciertos valores y escaseen en otros. La tabla de frecuencias es una de las formas de mostrarla, y no la única: la misma distribución se puede presentar como tabla, como gráfico o resumida en unas pocas medidas.
Todo el módulo de estadística descriptiva trata sobre este objeto. Cambia la herramienta; la distribución es siempre la misma.
2 · Para qué sirve
Una base de datos con 500 filas no se puede mirar. Una distribución de frecuencias la convierte en algo que entra en una pantalla y que se lee de un vistazo: qué categorías son frecuentes, cuáles son raras, dónde se concentran los datos y si hay valores sueltos lejos del resto.
Todo lo que viene después —los gráficos, el promedio, el desvío estándar— describe alguna propiedad de esta distribución. Por eso es el punto de partida.
3 · Los tres tipos de frecuencia
Para cada valor o categoría de la variable se obtienen tres números: uno se cuenta y los otros dos se calculan a partir de él.
Frecuencia absoluta : la cantidad de veces que aparece . Se cuenta y listo. La suma de todas es el total de casos:
Frecuencia relativa : qué parte del total representa esa categoría.
Frecuencia porcentual : la relativa multiplicada por cien, que es como se informa casi siempre.
La absoluta dice cuántos; la relativa y la porcentual dicen qué parte. Y esa diferencia es la que permite comparar dos grupos de distinto tamaño: 30 casos no significan lo mismo sobre 50 que sobre 5.000.
Cuando la variable es ordinal o cuantitativa se agrega un cuarto tipo, la frecuencia acumulada, que responde “¿cuántos hay hasta acá?”.
4 · Cómo cambia según el tipo de variable
La idea es la misma para cualquier variable, pero qué ocupa las filas cambia, y con eso cambia el orden en que van:
| Tipo de variable | Cada fila es | Cómo se ordenan las filas |
|---|---|---|
| Cualitativa nominal | Una categoría | Por frecuencia, o por una convención (alfabético, código oficial) |
| Cualitativa ordinal | Una categoría | Por el orden natural de la variable, siempre |
| Cuantitativa discreta con pocos valores | Un valor | Por el valor, de menor a mayor |
| Cuantitativa continua o con muchos valores | Un intervalo | Por el intervalo, de menor a mayor |
Dos decisiones que aparecen siempre que hay muchas categorías:
Cuándo agrupar en “otros”. Una tabla con treinta filas de las cuales veinte tienen dos o tres casos no se lee. Agrupar las menos frecuentes es legítimo si se cumplen dos condiciones: que la categoría agrupada quede claramente rotulada y que no esconda justamente lo que se quería mostrar. Si el trabajo es sobre una minoría, esa minoría no puede terminar adentro de “otros”.
Qué hacer con los casos sin dato. O se muestran como una fila propia —y el total incluye a todos—, o se calculan los porcentajes solo sobre los casos válidos y se declara el nuevo denominador. Las dos son correctas; lo que no es correcto es que el lector no sepa cuál se usó.
5 · Un ejemplo
Máximo nivel educativo alcanzado por las personas ocupadas, según la Encuesta Permanente de Hogares del primer trimestre de 2026:
| Nivel educativo | |||
|---|---|---|---|
| Sin instrucción | 30.675 | 0,002 | 0,2 % |
| Primario incompleto | 328.302 | 0,024 | 2,4 % |
| Primario completo | 1.467.428 | 0,109 | 10,9 % |
| Secundario incompleto | 2.007.555 | 0,149 | 14,9 % |
| Secundario completo | 4.210.831 | 0,313 | 31,3 % |
| Superior incompleto | 2.086.296 | 0,155 | 15,5 % |
| Superior completo | 3.340.549 | 0,248 | 24,8 % |
| Total | 13.471.636 | 1,000 | 100,0 % |
En la EPH, “superior” incluye el terciario: las dos últimas filas juntan institutos terciarios, universidad y posgrado. En la muestra, 3.044 de los 7.456 ocupados con nivel superior vienen del terciario. Leer el 40,3 % como “universitarios” lo sobreestima.
Las dos verificaciones que hay que hacer siempre: la columna suma el total de casos, y la columna suma 100 %. Y una tercera, que pide la sección anterior: entre los ocupados de esta base no hay ningún caso sin dato de nivel educativo, así que no hace falta una fila de “sin dato” ni cambiar el denominador. Si los hubiera, habría que decidirlo y declararlo.
Las filas van en el orden del nivel educativo y no de mayor a menor frecuencia: la variable es ordinal, y respetar su orden es lo que permite leer la tabla de arriba hacia abajo como una progresión.
6 · Cómo se interpreta
De la tabla se lee directamente que la categoría más frecuente —el modo— es secundario completo, con el 31,3 % de los ocupados. Y que el 59,7 % no accedió al nivel superior: .
Ojo con esa segunda afirmación, porque depende de dónde se ponga el corte. Si en vez de “no accedió al nivel superior” se dice “no completó el secundario”, la cifra pasa a ser 28,5 %. Ese número se calcula con los conteos (), no sumando los porcentajes ya redondeados, que darían 28,4 %. Son los mismos datos y dos afirmaciones muy distintas: el corte hay que declararlo siempre.
Redacción sugerida:
El 31,3 % de las personas ocupadas había completado el nivel secundario como máximo nivel alcanzado, y un 40,3 % adicional había accedido al nivel superior, completo o incompleto (EPH, 1º trimestre de 2026).
Cuando el grupo es chico, el porcentaje se informa siempre junto al conteo y al total. Un “50 %” sobre 4 casos y un “50 %” sobre 400 no merecen la misma confianza, y el lector solo puede darse cuenta si ve el denominador.
7 · Qué se le pregunta a una distribución
Una vez que la distribución está a la vista, describirla es contestar cuatro preguntas. Cada una tiene sus herramientas, y son las que ocupan el resto del módulo:
| La pregunta | Qué describe | Con qué se responde |
|---|---|---|
| ¿Dónde se concentra? | El centro | Media, mediana, modo |
| ¿Cuánto varían los datos? | La dispersión | Rango, rango intercuartílico, desvío estándar |
| ¿Qué forma tiene? | La simetría y las colas | Asimetría, curtosis |
| ¿Hay casos raros? | Los extremos | Valores atípicos, diagrama de caja |
Dos advertencias sobre el alcance de esta entrada. La primera: todo esto vale para una variable por vez; cuando se cruzan dos, la distribución pasa a ser conjunta y la herramienta es la tabla de contingencia. La segunda: esta es una distribución empírica, la de los datos que efectivamente se observaron. Más adelante aparecen las distribuciones teóricas —la normal, la binomial—, que son modelos matemáticos con los que se compara la empírica. Se parecen en el nombre y en el dibujo, pero una se cuenta y la otra se supone.
8 · Errores frecuentes
- Informar solo porcentajes cuando es chico. Con menos de 30 o 40 casos, un porcentaje suelto exagera la precisión: con 30 casos, un 50 % tiene un margen de error de unos 18 puntos para cada lado. Poné siempre el conteo al lado.
- Que los porcentajes no sumen 100. Si la suma da 99,9 o 100,1 es el redondeo y se aclara al pie. Si da 97 o 104, hay un error de cálculo o casos sin clasificar que no se están declarando. La excepción son las preguntas de respuesta múltiple —“¿qué medios de transporte usa?”—: cada persona puede marcar varias opciones, y los porcentajes sobre el total de personas suman más de 100 sin que haya ningún error. Hay que aclararlo al pie.
- Ordenar alfabéticamente una variable ordinal. Es lo que hace el software si nadie le dice lo contrario, y arruina la lectura de la tabla y del gráfico.
- Olvidarse de los valores faltantes. Los casos sin dato son parte del relevamiento. O se muestran como categoría aparte, o se aclara que los porcentajes se calcularon sobre los casos válidos — y ahí el denominador ya no es .
- Comparar dos grupos con frecuencias absolutas. Si un grupo tiene 200 casos y el otro 2.000, las columnas de conteos no se pueden comparar: hay que mirar las relativas de cada uno.
- Armar la distribución de una variable cuantitativa continua sin agrupar. Si cada valor aparece una sola vez, la tabla tiene tantas filas como casos y no resume nada. Ahí hay que usar intervalos de clase.
- Confundir frecuencia relativa con porcentaje. y son el mismo número expresado distinto. Escribir “0,35 %” es un error de dos órdenes de magnitud.
9 · En el software
# R
table(datos$nivel)                      # frecuencias absolutas
prop.table(table(datos$nivel))          # relativas
round(100 * prop.table(table(datos$nivel)), 1)   # porcentuales

# Para que respete el orden de una variable ordinal
datos$nivel <- factor(datos$nivel, levels = c("Primario", "Secundario", "Superior"),
                      ordered = TRUE)
# Python
datos["nivel"].value_counts() # absolutas
datos["nivel"].value_counts(normalize=True) # relativas
(100 * datos["nivel"].value_counts(normalize=True)).round(1) # porcentuales
# Para que respete el orden de una variable ordinal
orden = ["Primario", "Secundario", "Superior"]
datos["nivel"] = pd.Categorical(datos["nivel"], categories=orden, ordered=True)
datos["nivel"].value_counts(sort=False) # ahora sí, en ese ordenExcel: =CONTAR.SI(rango; criterio) por categoría, o una tabla dinámica
SPSS: Analizar › Estadísticos descriptivos › Frecuencias
InfoStat: Estadísticas › Tablas de frecuenciasTodo lo anterior cuenta casos de la muestra. Para obtener una tabla expandida como la del ejemplo, en vez de contar se suman los ponderadores de cada categoría:
# R: tabla expandida con el ponderador de la EPH
ocupados <- subset(eph, ESTADO == 1)
xtabs(PONDERA ~ NIVEL_ED, data = ocupados)
# Python
ocupados = eph[eph["ESTADO"] == 1]
ocupados.groupby("NIVEL_ED")["PONDERA"].sum()Excel: =SUMAR.SI(rango_nivel; categoría; rango_pondera)Herramientas de este tema
- CalculadoraTabla de frecuencias e histograma
- CalculadoraDescriptivos desde datos pegados
- PlantillaTabla de frecuencias automática
Seguir leyendo
Bioestadística · Fundamentos y descripción · 16 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 16 de 318
Probabilidad y Estadística · Fundamentos y descripción · 16 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 15 de 288
Estadística para la tesis · Los datos · 70 de 233
Cómo citar: Montivero, J. L. (2026). Distribución de frecuencias. estadistica.ar. https://estadistica.ar/conceptos/distribucion-de-frecuencias
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Distribución de frecuencias. estadistica.ar. https://estadistica.ar/conceptos/distribucion-de-frecuencias
BibTeX
@misc{estadistica_ar_distribucion_de_frecuencias,
  author       = {Montivero, Jorge Luis},
  title        = {{Distribución de frecuencias}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/distribucion-de-frecuencias}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.