estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/valores-atipicos
Valores atípicos: detección y tratamiento
Cómo se identifica un valor extremo, por qué 'atípico' no significa 'erróneo' y cuál es el único criterio legítimo para descartar un dato.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
Un valor atípico es una observación que se aparta notoriamente del resto del conjunto.
2 · Por qué importan
Porque afectan mucho a algunas medidas y nada a otras. La media, el desvío estándar, el rango y la correlación se mueven con un solo valor extremo; la mediana, el rango intercuartílico y los cuantiles, prácticamente no.
Y porque a veces son el dato más importante del conjunto: un caso de una enfermedad rara, una empresa que concentra la mitad del mercado, un mes con un salto de precios. Descartarlos por sistema es tirar la información que más explica.
3 · Los criterios de detección
Regla del rango intercuartílico. Es la más usada y la que dibuja el diagrama de caja:
Es atípico todo valor que quede por debajo del límite inferior o por encima del superior:
Con un factor de 3 en lugar de 1,5 se marcan los “extremos”.
Regla del puntaje z. Se considera atípico un valor con .
Regla del z robusto. La misma idea, pero con mediana y MAD en lugar de media y desvío, con un umbral habitual de 3,5, que propusieron Boris Iglewicz y David Hoaglin en 1993. Es la versión que no se deja engañar por los propios extremos. Tiene un punto débil: si más de la mitad de los datos son iguales, la MAD da cero y el puntaje no se puede calcular.
| Criterio | Qué usa | Robusto | Cuándo conviene |
|---|---|---|---|
| 1,5 · RIC | Cuartiles | Sí | El uso general; es lo que hace el boxplot |
| 3 · RIC | Cuartiles | Sí | Distinguir “extremos” dentro de los atípicos |
| Media y desvío | No | Solo con distribuciones aproximadamente normales | |
| z robusto > 3,5 | Mediana y MAD | Sí | Cuando hace falta un puntaje por caso, no solo un sí o un no |
Ninguno de los umbrales —el 1,5, el 3, el 3,5— tiene fundamento teórico fuerte: son convenciones calibradas para que marquen poco en una distribución normal.
4 · Un ejemplo
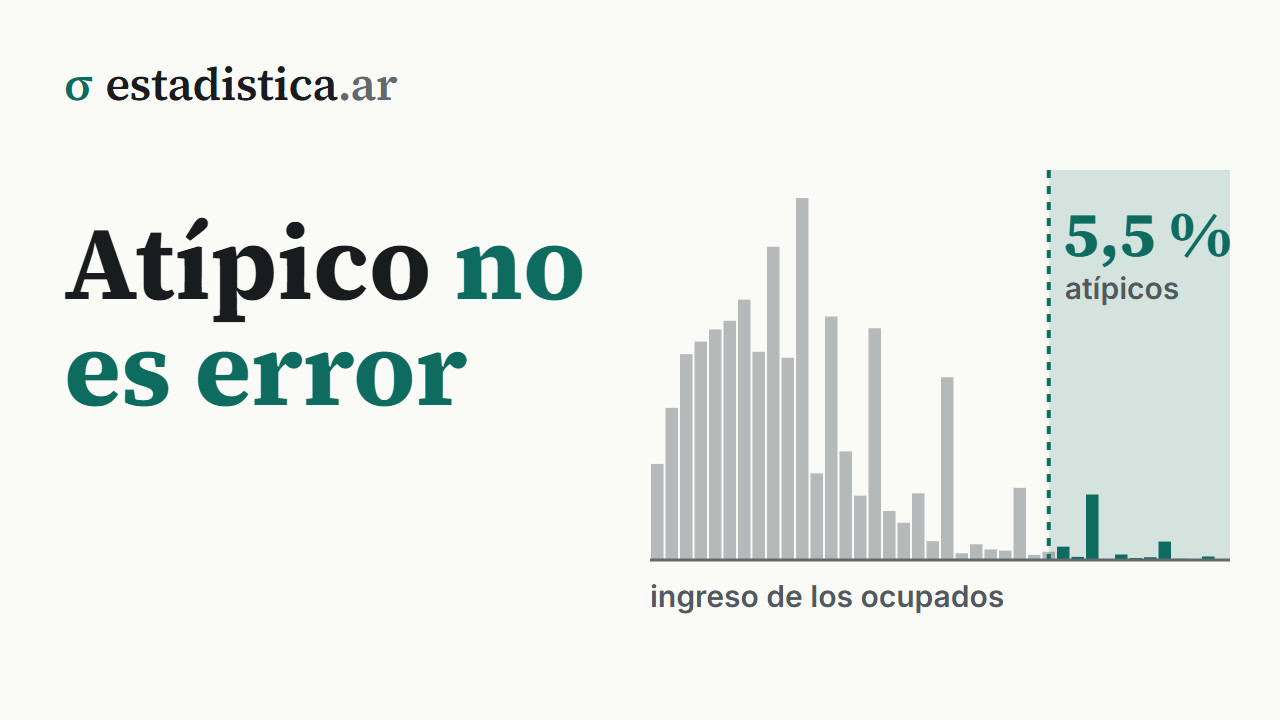
Con el ingreso de la ocupación principal (EPH, 1T 2026), el límite superior se calcula sobre un de $1.400.000 y un RIC de $900.000:
Por encima de ese límite hay un 5,5 % de los ocupados, ponderados con
PONDIIO: unas 720.000 personas. En una normal, por encima del límite superior
queda el 0,35 % —la mitad del 0,7 %, que cuenta los dos lados—, así que es unas
dieciséis veces más.
Los otros criterios dan resultados parecidos. Con 3 · RIC el límite sube a $4.100.000 y lo supera el 1,6 %; con el z robusto y un umbral de 3,5, el límite queda en $2.975.640 y marca el 5,1 %.
Es el ejemplo perfecto de por qué la regla señala y no condena. Si se eliminaran esos casos “para limpiar la distribución”, desaparecería exactamente la desigualdad que la variable está midiendo, y el ingreso medio caería artificialmente.
En cambio, con la edad de los mismos ocupados el límite superior da 78,5 años y lo superan 19 casos de 15.448, hasta los 88 años: un 0,1 %, menos de lo que marcaría la regla en una normal. Misma base, misma regla, resultados opuestos, porque una distribución tiene cola larga y la otra no.
5 · Los que no se ven mirando una variable
Todo lo anterior busca valores raros en una sola variable por vez, y eso deja escapar una clase entera: los casos cuyo valor es perfectamente normal en cada variable y absurdo en la combinación.
- Una persona de 22 años con 30 años de aportes.
- Una vivienda de 25 m² con seis dormitorios.
- Un hogar de dos integrantes con un gasto de alimentos de doce personas.
- Un municipio con mucha población y muy pocas viviendas.
Ninguno de esos casos aparece en un boxplot de ninguna de las dos variables. Se detectan mirando el diagrama de dispersión o, con más variables, midiendo cuán lejos está cada caso del centro de la nube con la distancia de Mahalanobis, que tiene en cuenta la correlación entre variables — ver medidas de distancia.
6 · Qué hacer con uno
El orden correcto, y no hay atajos:
1 · Verificar. ¿Es un error de carga, de codificación o de unidad? Una edad de 187, un peso de 0,07 kg, un ingreso con tres ceros de más. Si se puede corregir contra el instrumento original, se corrige.
2 · Entender de dónde salió. Cada origen pide una respuesta distinta:
| Origen | Qué corresponde |
|---|---|
| Error de carga o de unidad | Corregir contra el formulario, o marcar como faltante |
| El caso no pertenece a la población | Excluir, por criterio sustantivo y declarándolo |
| Variabilidad real del fenómeno | Se queda. Es el dato |
| Evento raro pero cierto | Se queda, y muchas veces se analiza aparte |
3 · Decidir el tratamiento. Si el dato es válido y pertenece a la población, se queda. Las opciones son:
- Mantenerlo y usar medidas robustas: mediana, RIC, métodos no paramétricos.
- Transformar la variable —el logaritmo es lo habitual con ingresos— para comprimir la cola.
- Recortar o winsorizar, declarándolo siempre: la media recortada descarta un porcentaje de cada extremo y la winsorizada los reemplaza por el último valor conservado.
- Analizar con y sin él y reportar las dos versiones. Es lo más transparente cuando un solo caso cambia la conclusión.
4 · Documentar. Todo lo que se excluyó, con cuántos casos y por qué.
7 · La única regla que importa
“Estaba fuera de 1,5 · RIC” no es una justificación. “El instrumento estaba descalibrado ese día” sí lo es. “El caso no pertenece a la población definida”, también.
Eliminar valores extremos porque molestan no es limpieza de datos. Si se hace para que el resultado dé lo que se buscaba, es manipular los datos.
8 · Errores frecuentes
- Eliminar por regla automática. El error central. La regla detecta, la persona decide.
- No declarar las exclusiones. Si se sacaron casos, va cuántos y por qué. Un trabajo donde el del análisis no coincide con el del relevamiento y nadie lo explica es un trabajo que no se puede evaluar.
- Usar la regla del en distribuciones asimétricas. Da resultados absurdos: con el ingreso, el límite inferior queda en negativo.
- Alarmarse por la cantidad de puntos marcados. Con muchos casos, decenas de atípicos son lo esperable incluso en datos impecables.
- Buscar solo atípicos univariados. Los errores de consistencia entre variables no aparecen en ningún boxplot.
- Confundir atípico con influyente. En regresión son cosas distintas: un valor puede ser extremo y no afectar el modelo, o ser moderado y cambiarlo entero. Ver observaciones influyentes.
- Buscar atípicos antes de mirar la distribución. Si la variable es asimétrica por naturaleza, la “cola de atípicos” es la forma esperable, no una anomalía.
- Winsorizar o recortar sin decirlo. Reemplazar los extremos por el percentil 5 y 95 es una técnica legítima; hacerlo en silencio, no.
- Suponer que un atípico es un error porque es grande. El ingreso máximo declarado en la EPH es de $40.000.000 y es perfectamente posible.
9 · En el software
# R — los límites y los casos
q <- quantile(datos$ingreso, c(0.25, 0.75))
lim <- q + c(-1.5, 1.5) * IQR(datos$ingreso)
which(datos$ingreso < lim[1] | datos$ingreso > lim[2])

# boxplot() los devuelve directamente
boxplot.stats(datos$ingreso)$out

# z robusto (mad() ya trae la constante 1,4826)
abs(datos$ingreso - median(datos$ingreso)) / mad(datos$ingreso) > 3.5

# Con el ponderador de la encuesta, los cuartiles ponderados
q <- Hmisc::wtd.quantile(datos$ingreso, datos$PONDIIO, c(0.25, 0.75))
boxplot.stats() calcula los cuartiles con las bisagras de Tukey y no con
quantile(): con pocos casos puede marcar atípicos distintos que las primeras
líneas del código. Ver diagrama de caja.
# Python
q1, q3 = datos["ingreso"].quantile([0.25, 0.75])
ric = q3 - q1
mask = (datos["ingreso"] < q1 - 1.5*ric) | (datos["ingreso"] > q3 + 1.5*ric)
datos[mask]

# Con el ponderador (NumPy 2.0 o posterior)
q1, q3 = np.quantile(datos["ingreso"], [0.25, 0.75],
                     weights=datos["PONDIIO"], method="inverted_cdf")
Excel: =CUARTIL.INC(rango; 1) y =CUARTIL.INC(rango; 3) en dos celdas,
y una columna con =O(A2 < Q1-1,5*RIC; A2 > Q3+1,5*RIC)
SPSS: Explorar › Gráficos (el boxplot etiqueta cada atípico con
su número de caso, que es lo que hace falta para ir a revisarlo)
InfoStat: Gráficos › Diagrama de cajaHerramientas de este tema
- CalculadoraDescriptivos desde datos pegados
Seguir leyendo
Bioestadística · Fundamentos y descripción · 48 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 47 de 318
Probabilidad y Estadística · Fundamentos y descripción · 48 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 44 de 288
Estadística para la tesis · Los datos · 92 de 233
Cómo citar: Montivero, J. L. (2026). Valores atípicos: detección y tratamiento. estadistica.ar. https://estadistica.ar/conceptos/valores-atipicos
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Valores atípicos: detección y tratamiento. estadistica.ar. https://estadistica.ar/conceptos/valores-atipicos
BibTeX
@misc{estadistica_ar_valores_atipicos,
  author       = {Montivero, Jorge Luis},
  title        = {{Valores atípicos: detección y tratamiento}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/valores-atipicos}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.