estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/diagrama-de-dispersion
Diagrama de dispersión
El gráfico que hay que hacer siempre antes de calcular una correlación: qué mostrar, qué mirar y cómo evitar que la nube se convierta en una mancha.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Qué es
Un diagrama de dispersión representa cada caso como un punto, con una variable en cada eje. Es el gráfico básico para dos variables cuantitativas.
2 · Un ejemplo
3 · Qué mirar, en este orden
1. Forma. ¿La relación es lineal, curva, escalonada? Si es curva, la correlación de Pearson la va a subestimar.
2. Dirección. ¿Sube, baja, o no se nota?
3. Intensidad. ¿Los puntos se agrupan alrededor de una línea o forman una mancha?
4. Atípicos. ¿Hay puntos alejados? Con pocos casos, uno solo puede cambiar todo: en una muestra simulada de 20, agregar un punto extremo lleva la correlación de 0,37 a 0,85. Con miles de casos un punto aislado pesa poco, pero una cola entera sí.
5. Grupos. ¿La nube se separa en subconjuntos? Casi siempre indica una tercera variable escondida, y es la antesala de la paradoja de Simpson.
6. Rarezas del registro. En la figura se ven columnas verticales: la gente declara 40, 45 o 48 horas, casi nunca 41 o 43. Ese amontonamiento en valores redondos es información sobre cómo se recogió el dato, no sobre la relación.
Aplicados a la figura, los seis pasos dan:
| Paso | Qué muestra la nube |
|---|---|
| Forma | Sube hasta unas 40 horas y después se aplana: no es una recta |
| Dirección | Positiva |
| Intensidad | Débil: mucha dispersión para cada cantidad de horas, |
| Atípicos | Una cola de ingresos altos que llega a $40.000.000 |
| Grupos | No se distinguen a simple vista |
| Registro | Columnas en 40, 45 y 48 horas |
Con esa lectura ya se sabe, antes de calcular nada, que Pearson va a quedar corto y que conviene mirar también Spearman.
4 · Qué eje va en cada lado
La convención: explicativa en el eje horizontal, respuesta en el vertical.
Se lee “el eje y depende del eje x”, y es la orientación que da sentido a una recta de regresión. Si ninguna variable explica a la otra, la elección es libre, pero conviene declararla.
5 · Por qué no alcanza con el coeficiente
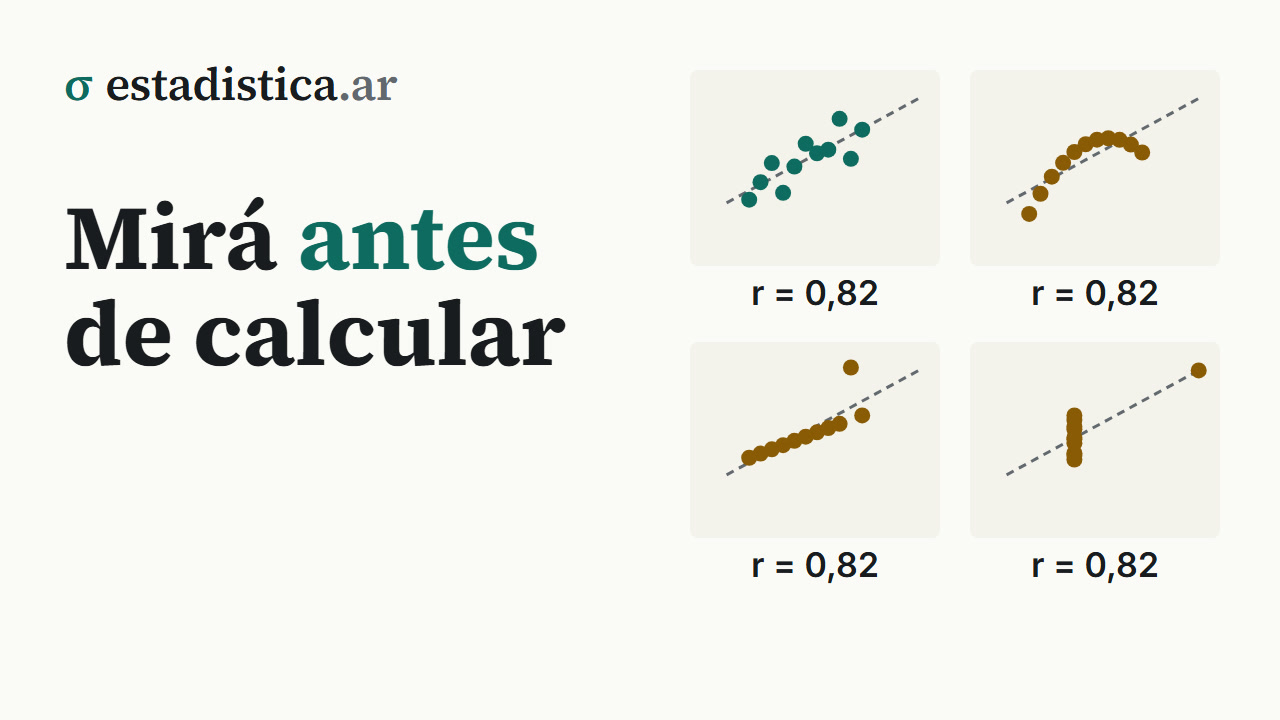
En 1973 Francis Anscombe armó cuatro conjuntos de once puntos cada uno para demostrar de una vez por todas que los resúmenes numéricos no reemplazan al gráfico. Los cuatro tienen los mismos estadísticos:
| Conjunto 1 | Conjunto 2 | Conjunto 3 | Conjunto 4 | |
|---|---|---|---|---|
| Media de | 9,00 | 9,00 | 9,00 | 9,00 |
| Media de | 7,50 | 7,50 | 7,50 | 7,50 |
| Correlación | 0,816 | 0,816 | 0,816 | 0,817 |
| Recta ajustada |
Y sin embargo son cuatro realidades distintas: el primero es una relación lineal razonable; el segundo, una curva perfecta que la recta no capta; el tercero es una recta casi exacta arruinada por un solo punto; y el cuarto no tiene ninguna relación —todos los casos comparten el mismo valor de salvo uno, que por sí solo produce toda la correlación—.
La versión moderna del argumento es el Datasaurus Dozen de Matejka y Fitzmaurice (2017): trece conjuntos —un dinosaurio, ideado por Alberto Cairo, y doce más— con la misma media, el mismo desvío y la misma correlación hasta dos decimales. Sirve para lo mismo y es más difícil de olvidar.
6 · Cuando hay demasiados puntos
Con miles de casos la nube se satura y deja de mostrar dónde está la densidad. Las soluciones, según el problema:
| Problema | Solución |
|---|---|
| Puntos superpuestos | transparencia (alfa) |
| Muchísimos casos | muestra aleatoria, declarándolo |
| Valores discretos amontonados | jitter: ruido mínimo para separarlos |
| Densidad muy desigual | hexágonos o curvas de nivel |
| Atípicos que aplastan la escala | recortar el eje y avisar |
En la figura de arriba se aplicaron tres de esas soluciones a la vez: transparencia, muestra de 3.500 casos y recorte de los dos ejes, todo declarado al pie.
Y lo que conviene agregarle:
- Una recta de regresión, si la relación es aproximadamente lineal.
- Una curva suavizada (loess), que muestra la forma real sin imponer linealidad. Es lo más útil para decidir si la recta corresponde.
- Color por una tercera variable, para revelar subgrupos.
- El y el coeficiente, si el gráfico va a circular solo.
7 · Cuando la escala esconde la relación
Con variables muy asimétricas —ingresos, población de ciudades, facturación— la nube se amontona en una esquina y el resto del gráfico queda vacío. No es un problema de cantidad de puntos sino de escala, y se resuelve pasando uno o los dos ejes a escala logarítmica.
| Qué se transforma | Qué relación se ve como recta |
|---|---|
| Solo el eje | Crecimiento porcentual constante: exponencial |
| Solo el eje | Efecto que se atenúa: logarítmica |
| Los dos ejes | Relación de potencia, |
La contraparte: el eje deja de leerse de manera intuitiva —la misma distancia representa multiplicar, no sumar— y hay que rotularlo con claridad. Ver transformación de variables.
8 · Errores frecuentes
- Calcular la correlación sin graficar. El cuarteto de Anscombe existe para demostrar exactamente esto.
- Poner la respuesta en el eje x.
- Truncar los ejes sin avisar.
- Empezar los ejes en cero por costumbre. En dispersión no es obligatorio: lo que importa es el rango de los datos.
- Unir los puntos con líneas. Eso es una serie de tiempo, no una dispersión.
- Usar escala logarítmica sin rotularla. El lector supone escala lineal salvo que se le diga lo contrario.
- Pasar a logaritmo una variable con ceros o negativos. El logaritmo no existe ahí: los casos desaparecen del gráfico sin aviso. Hay que filtrarlos o usar , y decirlo.
- Usarlo con variables categóricas. Ahí va un gráfico de barras agrupadas.
- No mirar los atípicos.
9 · En el software
# R base — d: ocupados con ingreso (P21 > 0) y horas válidas (PP3E_TOT < 999)
horas <- d$PP3E_TOT; ingreso <- d$P21
plot(horas, ingreso, pch = 16, col = rgb(0, 0, 0, 0.1))
abline(lm(ingreso ~ horas), col = "red", lwd = 2)
lines(lowess(horas, ingreso), col = "blue")

# ggplot2
library(ggplot2)
ggplot(data.frame(horas, ingreso), aes(horas, ingreso)) +
  geom_point(alpha = 0.15) +
  geom_smooth(method = "lm") +
  geom_smooth(method = "loess", se = FALSE, colour = "darkorange") +
  scale_y_log10()
# Sin method, geom_smooth usa gam —no loess— a partir de 1.000 casos.
# Con scale_y_log10, las dos curvas se ajustan sobre log(ingreso): la recta
# ya no es la de los pesos sin transformar.

# El cuarteto, que viene con R
data(anscombe); summary(anscombe)
# Python
import matplotlib.pyplot as plt
import seaborn as sns
horas, ingreso = d["PP3E_TOT"], d["P21"]
plt.scatter(horas, ingreso, alpha=0.15, s=8)
plt.yscale("log")
# lowess=True dibuja la curva suavizada en vez de la recta (requiere statsmodels)
sns.regplot(x=horas, y=ingreso, lowess=True, scatter_kws={"alpha": 0.15})Excel: Insertar › Gráfico de dispersión (XY)
Clic derecho sobre los puntos › Agregar línea de tendencia
Clic derecho en el eje › Dar formato al eje › Escala logarítmica
SPSS: Gráficos › Cuadros de diálogo antiguos › Dispersión/Puntos
› Dispersión simpleReferencias
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Matejka, J., & Fitzmaurice, G. (2017). Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing. En Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems (pp. 1290–1294). ACM. https://doi.org/10.1145/3025453.3025912
Todas las obras que cita el sitio están en la bibliografía.
Herramientas de este tema
Seguir leyendo
Bioestadística · Fundamentos y descripción · 55 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 54 de 318
Probabilidad y Estadística · Fundamentos y descripción · 54 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 51 de 288
Estadística para la tesis · Los datos · 106 de 233
Cómo citar: Montivero, J. L. (2026). Diagrama de dispersión. estadistica.ar. https://estadistica.ar/conceptos/diagrama-de-dispersion
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Diagrama de dispersión. estadistica.ar. https://estadistica.ar/conceptos/diagrama-de-dispersion
BibTeX
@misc{estadistica_ar_diagrama_de_dispersion,
  author       = {Montivero, Jorge Luis},
  title        = {{Diagrama de dispersión}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/diagrama-de-dispersion}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.