estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/frecuencia-acumulada
Frecuencia absoluta, relativa y acumulada
Qué responde cada tipo de frecuencia, cómo se acumulan y por qué la columna acumulada es la forma más rápida de ubicar la mediana y los cuartiles.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
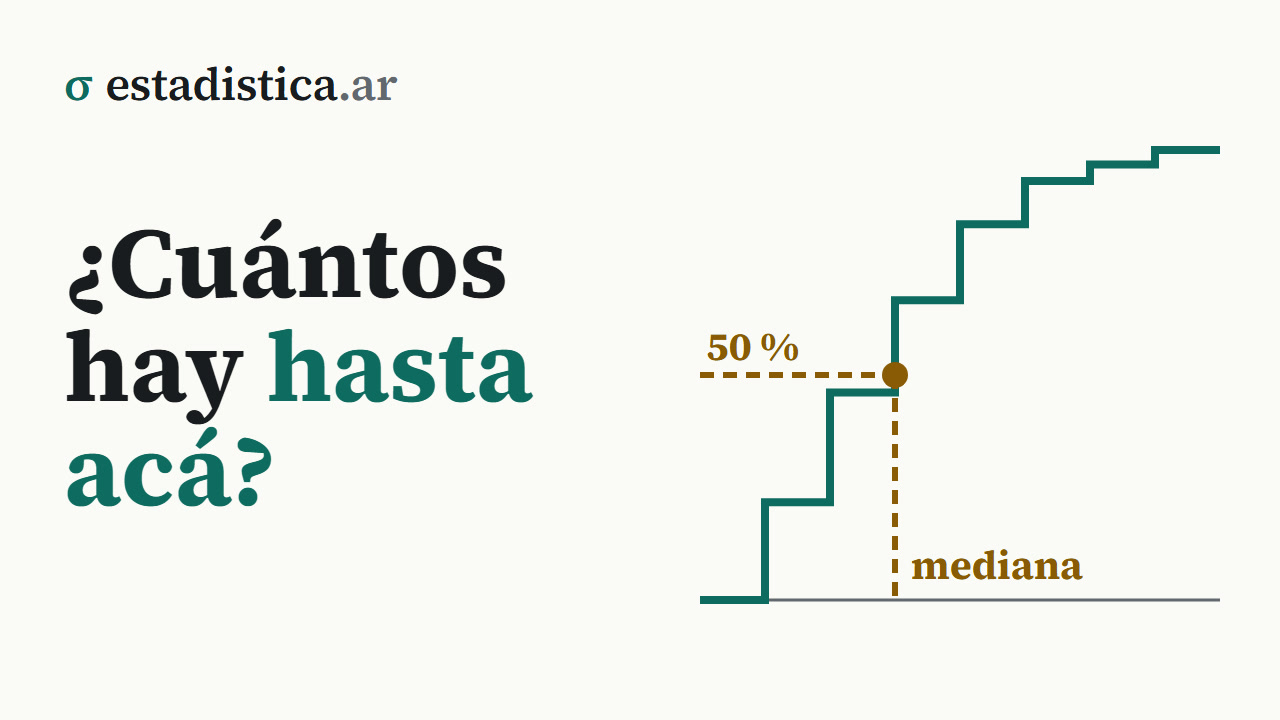
La frecuencia acumulada de un valor es la suma de las frecuencias de ese valor y de todos los anteriores. Responde “¿cuántos casos hay hasta acá?”.
2 · Para qué sirve
Para contestar preguntas de umbral, que son las más frecuentes en un informe: cuántos ganan menos de tanto, qué porcentaje tiene hasta secundario completo, cuántos hogares tienen 3 personas o menos.
Y para ubicar cuantiles sin calcular nada: donde la acumulada porcentual cruza el 50 % está la mediana; donde cruza el 25 % y el 75 %, los cuartiles.
“Cruza” quiere decir que la acumulada pasa de estar por debajo a estar por encima. Si en una fila da exactamente el 50 %, la mediana no es ese valor sino que queda entre él y el siguiente, y por convención se toma el punto medio de los dos. Con variables discretas y pocos valores, ese empate pasa más de lo que parece.
3 · Las cuatro columnas
Para la categoría o valor -ésimo, con categorías en total:
| Símbolo | Nombre | Qué responde |
|---|---|---|
| Frecuencia absoluta | ¿Cuántos casos hay en esta categoría? | |
| Frecuencia relativa | ¿Qué parte del total representan? | |
| Absoluta acumulada | ¿Cuántos hay en esta y en las anteriores? | |
| Relativa acumulada | ¿Qué parte del total hay hasta acá? |
Las acumuladas se construyen sumando hacia abajo:
Cuando la acumulada relativa se expresa en porcentaje se la anota ; en la salida de SPSS aparece como “Porcentaje acumulado”.
Dos propiedades que sirven de control. La última acumulada tiene que dar exactamente el total de casos y el 100 %:
Si no da, hay un error de suma, casos sin clasificar o categorías superpuestas. Y las acumuladas son no decrecientes: nunca bajan. Si en una tabla una acumulada baja, algo está mal.
4 · Un ejemplo
Personas por hogar en los 31 aglomerados urbanos de la EPH, primer trimestre de 2026:
| Personas | ||||
|---|---|---|---|---|
| 1 | 2.218.984 | 21,7 % | 2.218.984 | 21,7 % |
| 2 | 2.487.862 | 24,4 % | 4.706.846 | 46,1 % |
| 3 | 2.091.743 | 20,5 % | 6.798.589 | 66,6 % |
| 4 | 1.728.992 | 16,9 % | 8.527.581 | 83,5 % |
| 5 | 971.144 | 9,5 % | 9.498.725 | 93,1 % |
| 6 | 386.675 | 3,8 % | 9.885.400 | 96,8 % |
| 7 o más | 322.350 | 3,2 % | 10.207.750 | 100,0 % |
La columna se lee directamente:
- El 46,1 % de los hogares tiene 2 personas o menos.
- El 83,5 % tiene 4 o menos.
- La acumulada cruza el 50 % en la fila del 3, así que la mediana es 3.
- El cuartil 1 está donde cruza el 25 %: también en la fila del 2.
5 · “Hasta acá” y “de acá en adelante”
La acumulada que se usa casi siempre es la ascendente, de menor a mayor. Existe también la descendente, que responde “¿cuántos hay de este valor en adelante?” y se calcula restando:
En la primera fila la descendente es el total: todos los casos están “de ahí en adelante”.
En el ejemplo, los hogares de 5 personas o más son , el 16,5 %.
No hay que calcular las dos: una se deriva de la otra. Lo que sí hay que hacer es decir cuál se está mostrando, porque las dos se ven igual en una tabla.
6 · Con datos agrupados: manda el límite superior
Cuando las filas son intervalos y no valores sueltos, la acumulada se sigue construyendo igual, pero hay que tener claro a qué punto corresponde: al límite superior de la clase, no a su marca.
La razón es lo que la acumulada afirma. Decir que en la clase significa “hay 8.082.266 casos por debajo de 45”. Del punto medio —los 40 años— la tabla no dice nada, porque adentro de la clase ya no se sabe cómo se reparten los casos.
De ahí sale que la ojiva se dibuje uniendo los límites superiores, y de ahí sale también la manera de estimar un cuantil cuando lo único que hay es la tabla: interpolar dentro de la clase donde la acumulada cruza el porcentaje buscado, suponiendo que los casos se reparten parejo adentro de ella.
Un ejemplo con la tabla de edades de las personas ocupadas de 15 a 74 años que se arma en intervalos de clase (EPH, primer trimestre de 2026, ponderada). Las filas que hacen falta:
| Edad | |||
|---|---|---|---|
| 1.368.119 | 1.368.119 | 10,2 % | |
| 3.280.131 | 4.648.250 | 34,8 % | |
| 3.434.016 | 8.082.266 | 60,5 % | |
| … | … | … | … |
| Total | 13.359.544 | — | — |
La mitad de los casos —6.679.772— cae en la clase , que arranca con 4.648.250 acumulados y tiene 3.434.016 casos. Faltan entonces 2.031.522 casos para llegar a la mitad, y esa es la parte de la clase que hay que recorrer:
La mediana estimada es de 40,9 años. Con el mismo procedimiento sobre el 25 % sale un primer cuartil de 31,0 años; cambiando por la proporción que corresponda se obtiene cualquier cuantil.
¿Cuánto se equivoca? En este caso se puede saber, porque están los microdatos: la mediana de edad de los ocupados, calculada caso por caso, es de 40 años cumplidos, y el primer cuartil de 31. La interpolación se corrió menos de un año. Acá anduvo bien porque las clases son de diez años y los casos se reparten bastante parejo adentro de ellas; no siempre es así.
7 · La acumulada es una función
Mirada como un todo, la columna no es una lista de números sueltos: es una función que a cada valor le asigna la proporción de casos que no lo superan.
Si los casos tienen ponderador, como en la EPH, se cuentan pesos en lugar de casos:
Se la llama distribución acumulada empírica, y tiene forma de escalera: arranca en 0, salta en cada valor observado —el salto es la frecuencia relativa de ese valor— y termina en 1. Es la versión con datos de la función de distribución acumulada que aparece después con las distribuciones teóricas; el parecido no es casual, es la misma idea con datos en lugar de modelo.
Verla como función aclara algo práctico: la tabla se lee en las dos direcciones.
| Si se entra por… | Se obtiene | Ejemplo |
|---|---|---|
| Un valor | La proporción acumulada hasta ahí | “Hasta 3 personas hay un 66,6 %” |
| Una proporción | El valor donde se alcanza | “El 50 % se alcanza en 3 personas: la mediana” |
La primera lectura responde preguntas de umbral; la segunda da los cuantiles. Son la misma columna leída al derecho y al revés.
8 · Errores frecuentes
- Acumular una variable nominal. No existe “provincia de Salta o menos”. Es el error más común y el más grave de este tema.
- Acumular en el orden equivocado. Si la tabla está ordenada por frecuencia descendente en vez de por el orden natural de la variable, la acumulada no significa nada.
- Confundir con . Una diferencia de mayúscula que cambia por completo la lectura. Conviene rotular las columnas con palabras además de símbolos.
- Asociar la acumulada a la marca de clase. En datos agrupados, corresponde al límite superior del intervalo. Ubicarla en el punto medio desplaza la ojiva y arruina cualquier cuantil interpolado.
- Presentar la mediana interpolada como si fuera exacta. Es una estimación que supone reparto uniforme dentro de la clase; si se informa, se aclara que se calculó sobre datos agrupados.
- Que la última acumulada no dé el total. Casi siempre son casos faltantes que se filtraron sin declararlo.
- Leer mal el umbral. en la fila del 3 significa “3 o menos”, no “menos de 3”. La categoría propia está incluida.
- Sumar la columna acumulada. No se totaliza: en la fila de total va un guion.
9 · En el software
Los ejemplos usan la base de hogares de la EPH: IX_TOT es la cantidad de
miembros y PONDERA, el ponderador. Sin ponderar, la proporción de hogares con
3 personas o menos da 69,5 %; ponderada, el 66,6 % de la tabla.
# R
n  <- xtabs(PONDERA ~ IX_TOT, data = datos)   # frecuencias ponderadas
Ni <- cumsum(n)
Pi <- round(100 * cumsum(prop.table(n)), 1)
cbind(ni = as.vector(n), Ni, Pi)

# Proporción hasta un valor, ponderada
with(datos, sum(PONDERA[IX_TOT <= 3]) / sum(PONDERA))   # 0,666

# ecdf() arma la acumulada como función, pero cuenta casos sin ponderar:
# sirve para datos que no tienen ponderador
F <- ecdf(datos$IX_TOT)
F(3)          # 0,695 con la EPH: describe a la muestra, no a la población
# Python
import numpy as np
import pandas as pd
n = datos.groupby("IX_TOT")["PONDERA"].sum() # frecuencias ponderadas
tabla = pd.DataFrame({"ni": n, "Ni": n.cumsum(),
"Pi": (100 * n.cumsum() / n.sum()).round(1)})
# Proporción hasta un valor, ponderada
np.average(datos["IX_TOT"] <= 3, weights=datos["PONDERA"]) # 0,666Excel: =SUMA($B$2:B2) arrastrada hacia abajo
=SUMAR.SI(personas; "<=3"; pondera) / SUMA(pondera)
para un umbral suelto, ponderado
=CONTAR.SI(personas; "<=3") / CONTAR(personas)
si los datos no tienen ponderador
SPSS: Frecuencias ya devuelve la columna "Porcentaje acumulado"
InfoStat: Tablas de frecuencias, opción "frecuencias acumuladas"Herramientas de este tema
- CalculadoraTabla de frecuencias e histograma
- PlantillaTabla de frecuencias automática
Seguir leyendo
Bioestadística · Fundamentos y descripción · 19 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 19 de 318
Probabilidad y Estadística · Fundamentos y descripción · 19 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 18 de 288
Estadística para la tesis · Los datos · 73 de 233
Cómo citar: Montivero, J. L. (2026). Frecuencia absoluta, relativa y acumulada. estadistica.ar. https://estadistica.ar/conceptos/frecuencia-acumulada
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Frecuencia absoluta, relativa y acumulada. estadistica.ar. https://estadistica.ar/conceptos/frecuencia-acumulada
BibTeX
@misc{estadistica_ar_frecuencia_acumulada,
  author       = {Montivero, Jorge Luis},
  title        = {{Frecuencia absoluta, relativa y acumulada}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/frecuencia-acumulada}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.