estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/correlacion-de-pearson
Coeficiente de correlación de Pearson
La medida estándar de asociación lineal entre dos variables cuantitativas: qué mide exactamente y qué no detecta.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
El coeficiente de correlación de Pearson es la covarianza estandarizada:
2 · Sus propiedades
Va de −1 a +1. Los extremos son relación lineal perfecta; el 0, ausencia de relación lineal.
No tiene unidades, así que se puede comparar entre pares de variables distintas.
Es simétrico: . No distingue explicativa de respuesta.
No cambia con transformaciones lineales. Medir el ingreso en pesos o en miles de pesos da el mismo . Pero sí cambia con transformaciones no lineales: tomar logaritmos da otro coeficiente, cosa que no le pasa a Spearman.
Es sensible a los valores atípicos. Un solo punto extremo puede cambiarlo drásticamente, en cualquier dirección.
3 · Qué mide exactamente
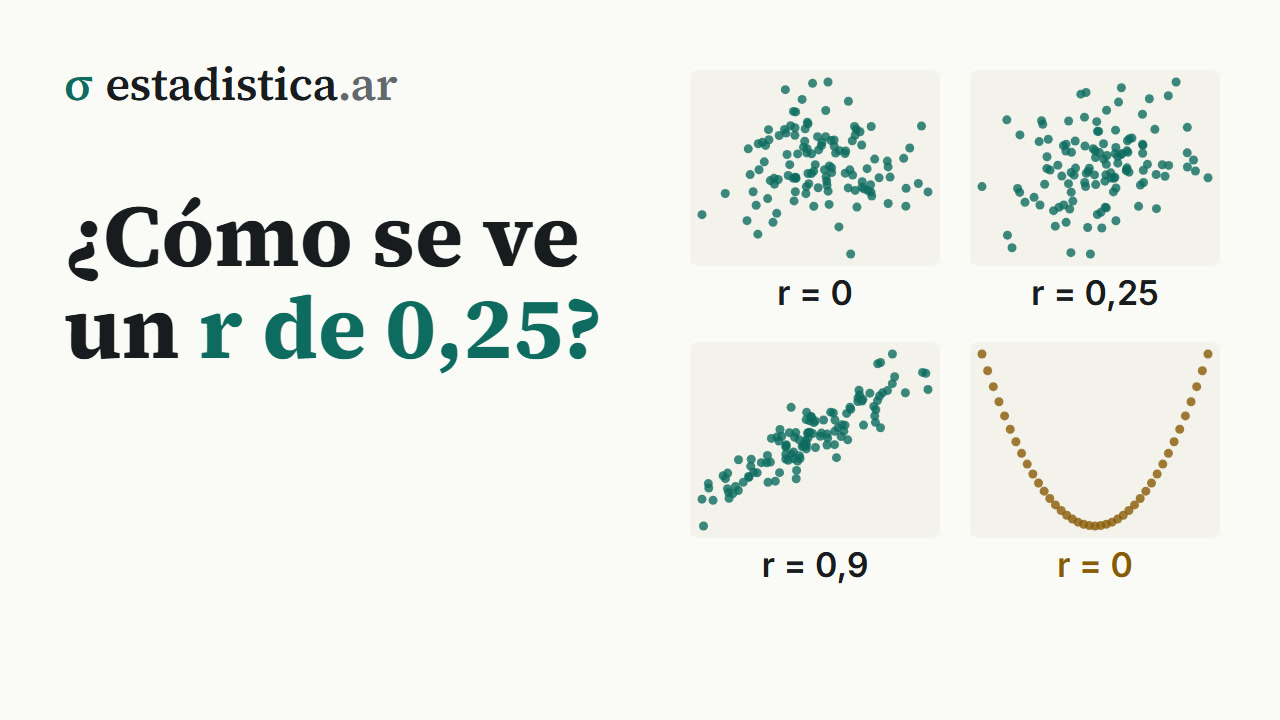
Relación lineal, y solo lineal. Es la limitación central y la fuente de casi todos los errores de interpretación.
Por eso el diagrama de dispersión va primero: el resume la nube en un número, y muchas nubes distintas dan el mismo número.
4 · Un ejemplo que muestra el problema
Entre horas trabajadas e ingreso mensual, en 14.212 ocupados de la EPH:
| Medida | Valor |
|---|---|
| Pearson | 0,249 |
| Spearman | 0,411 |
| Pearson sobre | 0,431 |
Los tres describen la misma relación. Pearson da bastante menos porque la relación no es lineal —el ingreso es muy asimétrico— y porque los valores extremos la distorsionan. Al tomar logaritmos, la relación se endereza y salta a 0,431, casi el valor de Spearman.
5 · Tres cosas que cambian el valor sin que cambie la relación
Antes de comparar dos correlaciones —entre estudios, entre grupos, entre períodos— conviene descartar que la diferencia venga de acá:
Restricción de rango. Si se analiza solo una parte del recorrido de una variable, la correlación baja. El caso clásico es el examen de ingreso: entre todos los postulantes, la nota de admisión predice razonablemente el desempeño posterior; calculada solo entre los admitidos —que son los de notas altas— la correlación se desploma, y eso se usa a veces para decir que el examen “no sirve”. El examen no cambió: cambió el rango.
Error de medición. Cualquier ruido en la medición de una de las dos variables atenúa la correlación hacia cero. Dos instrumentos poco fiables pueden mostrar una relación débil aunque los conceptos estén fuertemente relacionados; por eso en psicometría se informa la fiabilidad junto con las correlaciones.
Nivel de agregación. La correlación entre promedios de grupos casi siempre es mucho más alta que entre individuos, porque promediar borra la variabilidad interna. Una correlación de 0,3 entre personas puede ser de 0,8 entre departamentos con los mismos datos. No son comparables, y leer la segunda como si hablara de personas es falacia ecológica.
6 · Sus supuestos
Para que describa bien:
- Las dos variables son cuantitativas. Con ordinales va Spearman.
- La relación es aproximadamente lineal.
- No hay atípicos dominantes.
- No hay subgrupos que se comporten distinto.
Y para hacer inferencia sobre —prueba de significación o intervalo— hace falta además normalidad bivariada, o un grande.
7 · Significación e intervalo
La hipótesis nula es que no hay relación lineal en la población, , y se contrasta con un estadístico de grados de libertad:
El intervalo de confianza no se calcula directamente sobre , porque su distribución es asimétrica cerca de los extremos. Se pasa a la escala de Fisher, se construye el intervalo ahí y se vuelve:
Para el ejemplo, con da un intervalo de 0,234 a 0,264. Esa es la frase que conviene informar — y es también la transformación que hay que usar para promediar correlaciones de varios estudios o comparar dos entre sí.
8 · Errores frecuentes
- Concluir que no hay relación porque . Puede haber una curva.
- No graficar antes.
- Interpretarlo como porcentaje. Un de 0,5 no es “50 % de relación”; lo que se interpreta como proporción es , el coeficiente de determinación.
- Comparar correlaciones calculadas sobre rangos distintos o sobre distintos niveles de agregación.
- Usarlo con variables ordinales o categóricas.
- Calcularlo con atípicos sin analizarlos.
- Informar solo el valor p en muestras grandes, donde no distingue nada.
- Concluir causalidad. Ver correlación y causalidad.
- Promediar coeficientes de distintos grupos. No se promedian directamente: hay que pasar por la transformación z de Fisher.
9 · En el software
# R
cor(horas, ingreso)                        # 0.249
cor(horas, ingreso, use = "complete.obs")  # excluyendo faltantes
cor.test(horas, ingreso)                   # con IC y valor p

cor(datos)                                 # matriz de correlaciones
# Python
from scipy import stats
r, p = stats.pearsonr(horas, ingreso)
datos.corr() # matriz
# El intervalo, a mano con la z de Fisher
import numpy as np
z, se = np.arctanh(r), 1/np.sqrt(len(horas)-3)
np.tanh([z - 1.96*se, z + 1.96*se])Excel: =COEF.DE.CORREL(rango1; rango2)
SPSS: Analizar › Correlaciones › BivariadasHerramientas de este tema
Seguir leyendo
Bioestadística · Fundamentos y descripción · 57 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 56 de 318
Probabilidad y Estadística · Fundamentos y descripción · 56 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 53 de 288
Estadística para la tesis · Los datos · 107 de 233
Cómo citar: Montivero, J. L. (2026). Coeficiente de correlación de Pearson. estadistica.ar. https://estadistica.ar/conceptos/correlacion-de-pearson
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Coeficiente de correlación de Pearson. estadistica.ar. https://estadistica.ar/conceptos/correlacion-de-pearson
BibTeX
@misc{estadistica_ar_correlacion_de_pearson,
  author       = {Montivero, Jorge Luis},
  title        = {{Coeficiente de correlación de Pearson}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/correlacion-de-pearson}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-09-18}
}
Última actualización: 18 de septiembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.