estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/coeficiente-de-determinacion
Coeficiente de determinación R²
Qué proporción de la variabilidad explica el modelo, cómo se descompone la suma de cuadrados y por qué un R² alto no garantiza nada.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
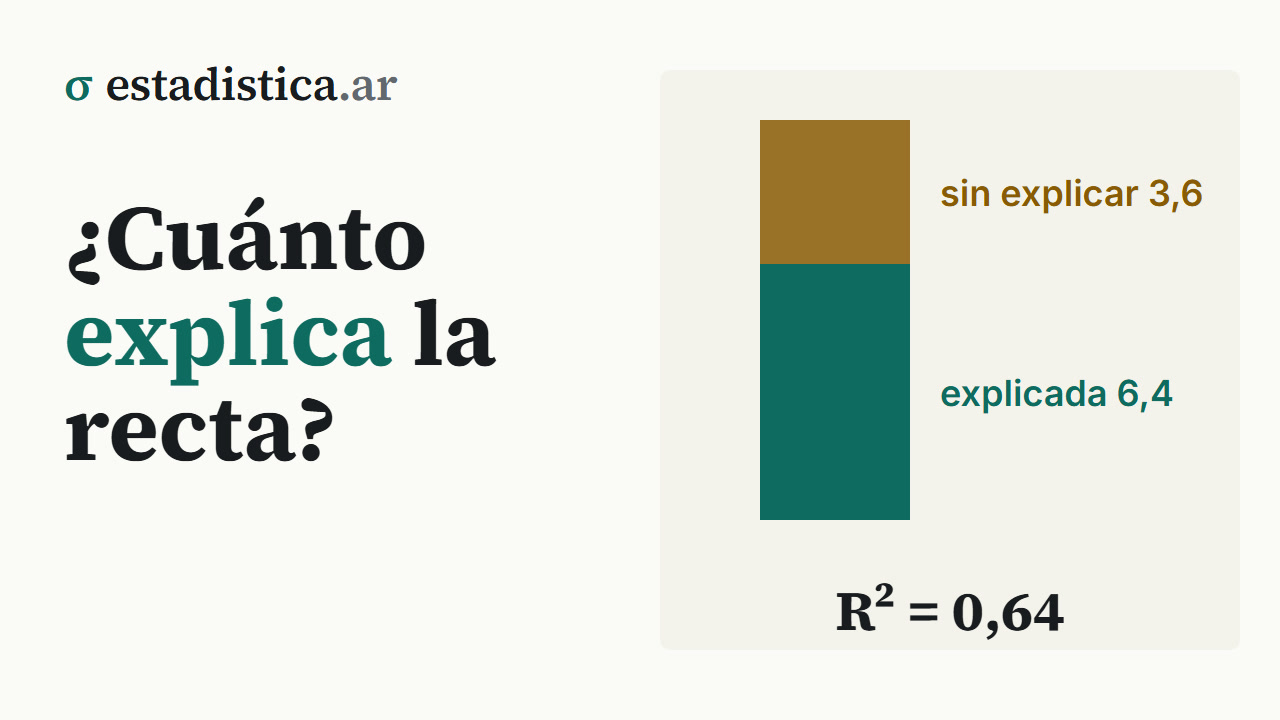
El coeficiente de determinación es la proporción de la variabilidad de que el modelo explica:
2 · La descomposición
Toda la variabilidad de se parte en dos:
| Componente | Cómo se calcula | Qué es |
|---|---|---|
| Total | cuánto varían los datos alrededor de su media | |
| Explicada | cuánto de eso reproduce la recta | |
| Residual | lo que queda sin explicar |
El es la explicada dividida por la total. Es la misma descomposición que usa el ANOVA, lo que no es casualidad: son el mismo modelo visto de dos maneras.
3 · Cómo se interpreta
Entre horas trabajadas e ingreso, .
Las horas trabajadas explican el 6,2 % de la variabilidad del ingreso de la ocupación principal. El 93,8 % restante depende de otros factores: el tipo de ocupación, la calificación, el sector, la antigüedad, la región.
4 · Qué valor es “bueno”
Depende por completo del campo, igual que con la correlación:
| Campo | típico |
|---|---|
| Física o ingeniería con datos de laboratorio | 0,95 o más |
| Modelos económicos agregados | 0,7 – 0,9 |
| Datos de encuesta a nivel individual | 0,1 – 0,3 |
| Predicción de comportamiento humano | 0,05 – 0,2 |
5 · Lo que un R² alto NO garantiza
No garantiza que el modelo sea correcto. Una relación curva ajustada con una recta puede dar un alto y estar mal especificada. Hay que mirar los residuos.
No garantiza causalidad.
No garantiza capacidad predictiva fuera de la muestra. Un modelo con muchas variables puede tener alto por sobreajuste y fallar con datos nuevos.
No dice si las predicciones son útiles. Para eso hay que mirar el error estándar residual, que está en las unidades de y es mucho más interpretable.
6 · Sube siempre al agregar variables
En regresión múltiple, agregar cualquier variable no puede bajar el , aunque sea ruido puro. Con suficientes variables se llega a 1 sin haber aprendido nada.
Por eso existen el ajustado, que penaliza la cantidad de predictores, y los criterios de información como AIC y BIC. Para comparar modelos con distinta cantidad de variables, el crudo no sirve.
7 · Tres situaciones donde el número confunde
Cuando se compara entre modelos con distinta variable dependiente. Un modelo para el ingreso y otro para el logaritmo del ingreso tienen que no se pueden comparar: la variabilidad total que están repartiendo es distinta. Es un error frecuente al elegir entre especificaciones.
Cuando se fuerza la recta por el origen. Si se ajusta sin ordenada, el software cambia la fórmula —compara contra cero en vez de contra la media— y devuelve un que suele ser altísimo y no significa lo mismo. Dos modelos, uno con intercepto y otro sin él, no se comparan por .
Cuando se evalúa fuera de la muestra. Ahí el puede ser negativo, y no es un error de cálculo: significa que el modelo predice peor que haber usado el promedio. Es una señal inequívoca de sobreajuste, y una de las razones por las que la validación con datos nuevos dice más que cualquier ajuste dentro de la muestra.
8 · Errores frecuentes
- Interpretarlo como calidad del modelo en abstracto.
- Compararlo entre modelos con distinta variable dependiente. Solo es comparable con el mismo , en la misma escala.
- Comparar un modelo con intercepto con otro sin intercepto.
- Usar el crudo para comparar modelos con distinta cantidad de predictores.
- Concluir causalidad desde un alto.
- Descartar un modelo por un bajo, cuando la pregunta es si existe la relación y de qué magnitud.
- Reportar solo el sin la pendiente ni su intervalo, que es lo que responde la pregunta sustantiva.
- Olvidar mirar los residuos.
9 · En el software
# R
modelo <- lm(ingreso ~ horas, data = d)
summary(modelo)$r.squared          # 0.0621
summary(modelo)$adj.r.squared

# La descomposición a mano
sct <- sum((d$ingreso - mean(d$ingreso))^2)
scr <- sum(residuals(modelo)^2)
1 - scr / sct                      # el mismo 0.0621
# Python
from scipy import stats
r = stats.linregress(horas, ingreso).rvalue
r**2
import statsmodels.formula.api as smf
smf.ols("ingreso ~ horas", data=d).fit().rsquaredExcel: =COEFICIENTE.R2(y; x)
o mostrar R² en la línea de tendencia del gráficoHerramientas de este tema
- CalculadoraCorrelación y regresión simple
- SimuladorAjustá la recta a mano
Seguir leyendo
Bioestadística · Fundamentos y descripción · 66 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 65 de 318
Probabilidad y Estadística · Fundamentos y descripción · 65 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 63 de 288
Estadística para la tesis · Los datos · 116 de 233
Cómo citar: Montivero, J. L. (2026). Coeficiente de determinación R². estadistica.ar. https://estadistica.ar/conceptos/coeficiente-de-determinacion
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Coeficiente de determinación R². estadistica.ar. https://estadistica.ar/conceptos/coeficiente-de-determinacion
BibTeX
@misc{estadistica_ar_coeficiente_de_determinacion,
  author       = {Montivero, Jorge Luis},
  title        = {{Coeficiente de determinación R²}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/coeficiente-de-determinacion}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-09-18}
}
Última actualización: 18 de septiembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.