estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/paradoja-de-simpson
La paradoja de Simpson
Cuando la relación que se ve en el total desaparece o se invierte al mirar por subgrupos: el caso extremo de la confusión.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Qué es
La paradoja de Simpson ocurre cuando una relación observada en los datos agregados desaparece, se debilita o se invierte al analizar los subgrupos por separado.
2 · La versión atenuada, con datos reales
Tasa de empleo no registrado entre asalariados de la EPH:
| Varones | Mujeres | Brecha | |
|---|---|---|---|
| Global | 35,7 % | 39,4 % | −3,7 pts |
| Primario incompleto | 59,0 % | 70,3 % | −11,4 |
| Primario completo | 50,1 % | 63,0 % | −12,9 |
| Secundario incompleto | 54,7 % | 68,5 % | −13,8 |
| Secundario completo | 34,0 % | 46,5 % | −12,6 |
| Superior incompleto | 33,1 % | 42,8 % | −9,7 |
| Superior completo | 13,2 % | 15,2 % | −2,0 |
La brecha global es tres veces menor que la de casi todos los estratos.
El motivo es la composición: las mujeres de la muestra están más concentradas en los niveles educativos altos, que son los de menor informalidad. Esa ventaja educativa compensa parte de la desventaja dentro de cada nivel, y el agregado muestra una brecha mucho más chica que la real.
3 · La versión con reversión
Un ejemplo construido —los números son inventados a propósito, para que la reversión sea nítida— de dos tratamientos:
| Tratamiento A | Tratamiento B | |
|---|---|---|
| Casos leves | 93 % (81/87) | 87 % (234/270) |
| Casos graves | 73 % (192/263) | 69 % (55/80) |
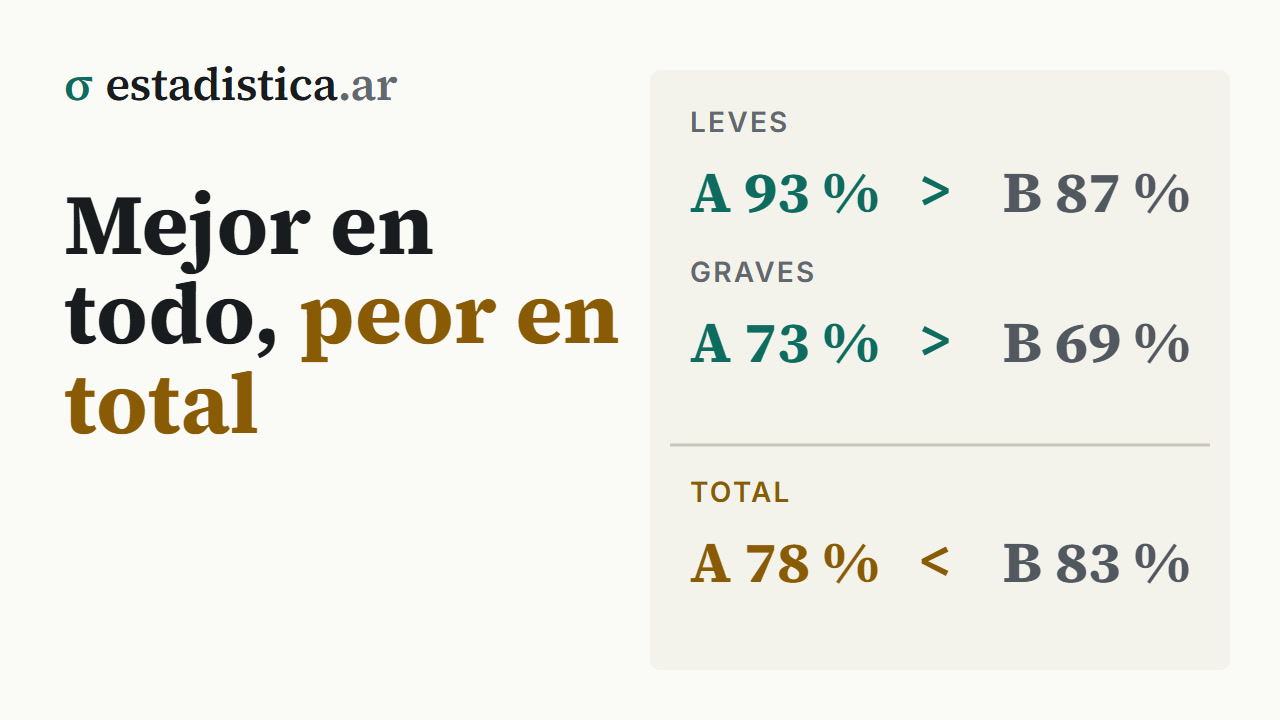
| Total | 78 % (273/350) | 83 % (289/350) |
A es mejor en los leves, mejor en los graves, y peor en el total.
La explicación es el desbalance: A se aplicó mayoritariamente a casos graves —263 de 350—, donde cualquier tratamiento tiene peor tasa de éxito. El promedio global de A está arrastrado por la composición de sus pacientes, no por su calidad.
Esa lectura da la condición para que la reversión ocurra: hace falta que la variable de estratificación esté fuertemente desbalanceada entre los grupos y que además afecte mucho al resultado. Si los dos tratamientos se hubieran aplicado a mitades iguales de leves y graves, el total habría coincidido con los estratos y no habría paradoja alguna.
4 · El caso histórico
El ejemplo más citado es el de las admisiones de posgrado de la Universidad de Berkeley en 1973: en el agregado la tasa de admisión de los varones era claramente mayor que la de las mujeres, pero al desagregar por departamento la mayoría de los departamentos admitía a las mujeres en igual o mayor proporción.
La explicación fue de composición: las mujeres se postulaban en mayor medida a departamentos con tasas de admisión bajas para todos. El caso es célebre porque muestra que el dato agregado puede sugerir una discriminación que el desagregado no confirma —y también porque la elección de a qué departamento postularse no es ajena al problema que se quería estudiar—.
5 · También pasa con variables numéricas
La paradoja no es exclusiva de porcentajes y tablas: aparece igual con correlaciones y con pendientes de regresión.
La forma típica es una nube de puntos con pendiente positiva en el conjunto y negativa dentro de cada grupo —o al revés—. Ocurre cuando los grupos están escalonados: cada uno ocupa una zona distinta del gráfico y la recta global termina describiendo las diferencias entre grupos en vez de la relación dentro de cada uno. Es la misma cuenta de siempre: la correlación total mezcla variación entre grupos con variación interna.
6 · Cuál resultado es el correcto
Depende de la pregunta, y esta es la parte que no se resuelve con Estadística:
| Pregunta | Nivel correcto |
|---|---|
| ¿Qué le conviene a este paciente, que tiene un cuadro grave? | Desagregado |
| ¿Cuántas personas están en empleo no registrado hoy? | Agregado |
| ¿Hay desigualdad de género en la informalidad? | Desagregado, porque la educación es confusora |
| ¿Cuál es la brecha total que enfrenta la política pública? | Agregado, porque es el efecto neto |
7 · Cómo protegerse
Desagregar siempre. Antes de publicar una comparación agregada, mirarla por los subgrupos relevantes.
Comparar el crudo con el ajustado. Si difieren mucho, hay confusión y hay que explicarla.
Estandarizar. La estandarización directa aplica la misma estructura poblacional a los dos grupos y elimina el efecto de composición. Es el método clásico en demografía y salud, y existe justamente para esto.
Desconfiar de los promedios de poblaciones heterogéneas. Sobre todo cuando los grupos comparados tienen composiciones muy distintas.
Y al comparar dos momentos, preguntarse si cambió la composición. Una serie puede moverse sin que ninguno de sus componentes se haya movido.
8 · Errores frecuentes
- Reportar solo el agregado en poblaciones heterogéneas.
- Reportar solo el desagregado cuando la pregunta es sobre el total.
- Creer que hay un resultado “verdadero” independiente de la pregunta.
- Desagregar hasta que aparezca el resultado buscado. Es p-hacking.
- Desagregar en grupos con muy pocos casos.
- Atribuir a un cambio real lo que fue un cambio de composición.
- Estratificar por un mediador y concluir que el efecto desapareció.
9 · En el software
# R — el reflejo básico: mirar global y por estrato
tapply(noreg, sexo, mean)                    # global
tapply(noreg, list(sexo, nivel_ed), mean)    # por estrato

# Con dplyr
d |> group_by(sexo) |> summarise(tasa = mean(noreg))
d |> group_by(nivel_ed, sexo) |> summarise(tasa = mean(noreg), n = n())

# La versión numérica: pendiente global contra pendientes por grupo
coef(lm(y ~ x, d))
d |> group_by(grupo) |> summarise(pendiente = coef(lm(y ~ x))[2])
# Python
d.groupby('sexo').noreg.mean()
d.groupby(['nivel_ed', 'sexo']).noreg.agg(['mean', 'size'])Referencias
- Bickel, P. J., Hammel, E. A., & O'Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398–404. https://doi.org/10.1126/science.187.4175.398
Todas las obras que cita el sitio están en la bibliografía.
Herramientas de este tema
- SimuladorLa paradoja de Simpson
Seguir leyendo
Bioestadística · Fundamentos y descripción · 63 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 62 de 318
Probabilidad y Estadística · Fundamentos y descripción · 63 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 60 de 288
Estadística para la tesis · Los datos · 113 de 233
Cómo citar: Montivero, J. L. (2026). La paradoja de Simpson. estadistica.ar. https://estadistica.ar/conceptos/paradoja-de-simpson
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). La paradoja de Simpson. estadistica.ar. https://estadistica.ar/conceptos/paradoja-de-simpson
BibTeX
@misc{estadistica_ar_paradoja_de_simpson,
  author       = {Montivero, Jorge Luis},
  title        = {{La paradoja de Simpson}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/paradoja-de-simpson}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-09-18}
}
Última actualización: 18 de septiembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.