estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/matriz-de-datos
La matriz de datos
La tabla donde cada fila es un caso y cada columna una variable: el formato en el que todo software espera recibir los datos, y por qué conviene respetarlo.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
La matriz de datos es la tabla en la que se organiza la información para analizarla: cada fila es un caso de la unidad de análisis y cada columna es una variable.
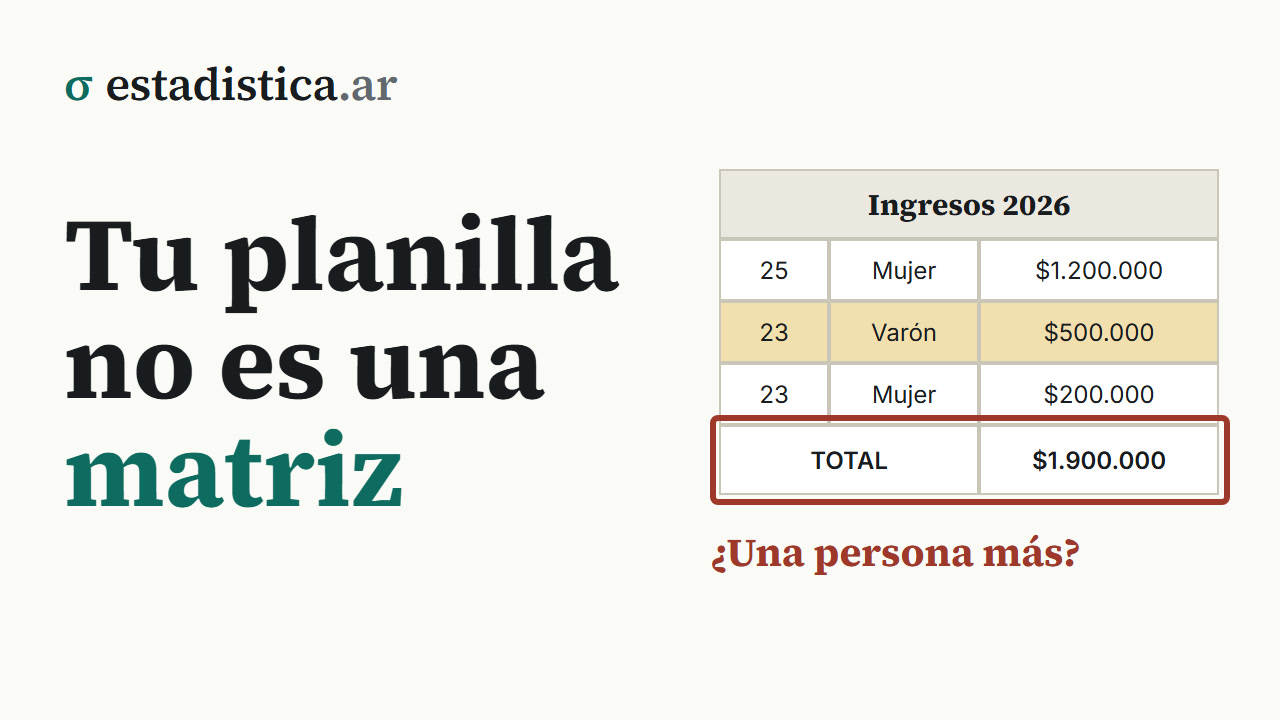
Según el contexto se la llama también base de datos, planilla, data frame (en R y Python) o dataset: son nombres distintos para la misma tabla.
La observación casi siempre es un caso de la unidad de análisis, pero no siempre: si a cada paciente se lo mide tres veces, la fila puede ser la medición, y la unidad de análisis sigue siendo el paciente —ver unidad de análisis—.
Esa forma de organizar los datos tiene nombre propio —datos ordenados, o tidy data, como los bautizó Hadley Wickham en 2014— y se resume en tres reglas que conviene tener juntas, porque la tercera casi nunca se enseña:
- Cada variable es una columna.
- Cada observación es una fila.
- Cada tipo de unidad tiene su propia tabla.
Las dos primeras son la definición de arriba. La tercera dice que si un estudio mide cosas de personas y cosas de hogares, no hay una matriz sino dos, y eso tiene su sección.
2 · Para qué sirve
Todo el software estadístico espera recibir los datos así: R, Python, SPSS, InfoStat y las tablas dinámicas de Excel están construidos sobre esa estructura.
Una planilla que no respeta la estructura no se puede analizar sin rearmarla antes, y ese rearmado es donde se generan la mayoría de los errores de un trabajo: se pierden casos, se corren columnas, se duplican filas.
3 · La estructura
| Variable 1 | Variable 2 | Variable 3 | |
|---|---|---|---|
| Caso 1 | dato | dato | dato |
| Caso 2 | dato | dato | dato |
| Caso 3 | dato | dato | dato |
Cinco reglas que hacen que funcione:
Una sola fila de encabezados, con nombres cortos, sin espacios ni acentos y
sin repetirse. nivel_ed funciona en cualquier software; Nivel Educativo Alcanzado (máximo) da problemas en varios.
Una sola cosa por celda. Si en una celda dice “35 años, secundario completo”, son dos variables y van en dos columnas.
Nada más que datos. Sin títulos arriba, sin filas de totales al final, sin celdas combinadas, sin colores que signifiquen algo, sin notas al pie intercaladas. Todo eso va en otra hoja.
Números como números. Sin puntos de miles, sin signo de peso, sin unidades
dentro de la celda: 1200000, no $ 1.200.000 ni 1.200.000 pesos. Un número
escrito así se lee como texto o, peor, como otro número: según la configuración
regional, «1.200» puede quedar en mil doscientos o en uno coma dos. La unidad va
en el nombre de la columna o en el diccionario.
Una columna que identifique al caso. No es obligatoria para que el software lea el archivo, pero sin ella se trabaja a ciegas: un número de caso, de historia clínica, de formulario. Sirve para tres cosas que tarde o temprano hacen falta: volver al cuestionario en papel cuando un valor es raro, detectar duplicados con certeza —dos filas idénticas pueden ser un error de carga o dos personas que respondieron lo mismo, y solo el identificador lo distingue— y unir esta tabla con otra.
4 · Lo que no es una matriz de datos
La confusión más cara de este tema es cargar en la planilla una tabla que ya está resumida. Son dos objetos distintos:
| Matriz de datos | Tabla de resultados | |
|---|---|---|
| Qué hay en una fila | Un caso | Una categoría o un grupo |
| Qué hay en una celda | Un dato observado | Un recuento o una medida calculada |
| De dónde sale | Del relevamiento | De analizar la matriz |
| Qué se puede hacer con ella | Cualquier análisis | Leerla |
Una tabla de frecuencias o una tabla de contingencia son resultados: ya perdieron los casos individuales. Con la matriz se puede llegar a ellas en un paso; al revés no, o solo con pérdidas —ver datos agrupados—.
5 · Un ejemplo
Así se ve un fragmento del extracto del caso de los ingresos de la EPH:
| aglomerado | sexo | edad | nivel_ed | cat_ocup | ingreso_ocup_principal | ponderador |
|---|---|---|---|---|---|---|
| 22 | 1 | 31 | 5 | 3 | 280000 | 124 |
| 32 | 2 | 51 | 6 | 3 | 1700000 | 1787 |
| 33 | 1 | 53 | 2 | 3 | 1389000 | 4784 |
Cada fila es una persona; cada columna, una variable. Los valores son códigos, y lo que traduce esos códigos es el diccionario de variables, que va aparte: el aglomerado 22 es Gran Catamarca, el 32 la Ciudad de Buenos Aires y el 33 los partidos del Gran Buenos Aires.
6 · Cuando hace falta más de una matriz
Es la tercera regla de los datos ordenados, y la que más se pasa por alto: una tabla por cada tipo de unidad. En cuanto un estudio mide cosas de dos niveles —personas y hogares, alumnos y escuelas, pacientes y consultas— forzar todo en una sola tabla trae problemas.
Si se ponen los datos del hogar en la fila de cada persona, el ingreso total familiar aparece repetido tantas veces como integrantes tenga, y basta un descuido para sumarlo cinco veces. Por eso la EPH publica dos bases, una de hogares y otra de personas: no es una duplicación, es la tercera regla aplicada.
Lo que las mantiene unidas es una clave: una o más columnas presentes en las dos que identifican al hogar. Con esa clave se juntan cuando hace falta —para analizar personas con una variable del hogar, por ejemplo—, y la unión se hace en el momento del análisis y no en el de la carga.
| Tabla | Una fila es | Clave en un esquema propio | Clave en la EPH |
|---|---|---|---|
| Hogares | Un hogar | id_hogar | CODUSU + NRO_HOGAR |
| Personas | Una persona | id_hogar + nro_componente | CODUSU + NRO_HOGAR + COMPONENTE |
En la EPH la clave del hogar son dos columnas porque CODUSU identifica la
vivienda y en una vivienda puede haber más de un hogar. Y si se apilan varios
trimestres, la clave suma el año y el trimestre: el detalle, con el código para
unir las dos bases, está en unidad de análisis.
7 · Cómo se interpreta
Mirar la matriz antes de analizar contesta preguntas que después son caras:
- ¿Cuántas filas hay? Tiene que coincidir con la cantidad de casos relevados. Si no coincide, hay duplicados o pérdidas.
- ¿El identificador se repite? Es la forma segura de detectar duplicados: dos filas con el mismo identificador son un error de carga aunque el resto de los valores difiera.
- ¿Qué hay en las celdas vacías? Un blanco puede ser “no contestó”, “no corresponde” o “nos olvidamos de cargarlo”, y las tres cosas se tratan distinto. Ver datos faltantes.
- ¿Los valores son posibles? Una edad de 150, un ingreso negativo o un código de provincia que no existe se detectan mirando mínimos y máximos de cada columna, no leyendo fila por fila.
8 · Errores frecuentes
- Celdas combinadas. Son el enemigo número uno. Al exportar, el valor queda en la primera celda y el resto vacías, y el archivo se desarma.
- Encabezados en dos filas. Una fila con “Ingreso” abarcando tres columnas y otra abajo con “2024 / 2025 / 2026”. Es legible para una persona e ilegible para un programa: esas son tres variables con tres nombres.
- Totales dentro de la matriz. Una fila “TOTAL” al final se lee como un caso más y duplica todo. Los totales se calculan, no se guardan.
- Una fila por medición en vez de por caso. Si medís a cada paciente tres veces, hay que decidir si la unidad es el paciente o la medición. Las dos formas son válidas y tienen nombre: ver formato ancho y largo.
- Guardar el significado en el formato. Pintar de rojo las filas dudosas no sirve: el color no se exporta. Si una marca importa, va en una columna.
- Usar el mismo símbolo para faltante y para cero. Un ingreso vacío y un ingreso de cero son cosas distintas, y confundirlos corre todos los promedios.
- Dejar los códigos de faltante como si fueran valores. Un 99 en la edad o un −9 en el ingreso no son datos: son «no sabe» o «no contesta». Si no se declaran como faltantes antes de calcular, entran al promedio como cualquier otro número.
- Abrir un CSV argentino como si fuera inglés. Un Excel configurado en
español exporta con
;como separador y coma decimal. Leído con las opciones por defecto de R o de Python, queda todo en una sola columna, o los decimales se convierten en texto.
9 · En el software
# R — leer un CSV exportado por un Excel en español (separador ";", coma decimal)
datos <- read.csv2("datos.csv")

# Lo primero que se hace con cualquier base
dim(datos)                 # cuántas filas y columnas
str(datos)                 # tipo de cada columna
summary(datos)             # mínimos, máximos y faltantes de un vistazo
anyDuplicated(datos$id)    # 0 si ningún identificador se repite
# Python — el mismo CSV
import pandas as pd
datos = pd.read_csv("datos.csv", sep=";", decimal=",")
datos.shape
datos.info()
datos.describe(include="all")
datos["id"].duplicated().any() # False si ningún identificador se repiteExcel: Ctrl+Fin lleva a la última celda con datos: si cae más lejos
de lo esperado, hay basura abajo o a la derecha
SPSS: Vista de variables (define) / Vista de datos (la matriz)Para la carga misma —cómo evitar los errores antes de que lleguen a la matriz— ver carga de datos sin errores.
Referencias
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Todas las obras que cita el sitio están en la bibliografía.
Herramientas de este tema
Seguir leyendo
Bioestadística · Fundamentos y descripción · 9 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 9 de 318
Probabilidad y Estadística · Fundamentos y descripción · 9 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 9 de 288
Estadística para la tesis · Los datos · 64 de 233
Cómo citar: Montivero, J. L. (2026). La matriz de datos. estadistica.ar. https://estadistica.ar/conceptos/matriz-de-datos
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). La matriz de datos. estadistica.ar. https://estadistica.ar/conceptos/matriz-de-datos
BibTeX
@misc{estadistica_ar_matriz_de_datos,
  author       = {Montivero, Jorge Luis},
  title        = {{La matriz de datos}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/matriz-de-datos}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.