estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/estadistica-en-sql
Estadística en SQL: qué hace cada motor por defecto
Promedios, tasas, uniones y valores vacíos en SQLite, PostgreSQL y DuckDB: la misma consulta, tres motores, y los resultados que cambian sin avisar.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Un lenguaje, varios motores
SQL es el lenguaje con que se consultan las bases de datos. Muchos datos públicos viven en una base antes de llegar a una planilla, y buena parte del trabajo con datos empieza con una consulta: filtrar, agrupar, unir tablas, contar. SQL es un estándar, pero cada programa que lo ejecuta (cada motor) lo interpreta con sus propias reglas, y la misma consulta puede devolver números distintos.
Esta página compara tres:
- SQLite, que viene adentro de Python, de los celulares y de muchos programas, y guarda toda la base en un archivo.
- PostgreSQL, el motor más usado en organismos y sistemas web.
- DuckDB, pensado para análisis de datos, que crece rápido entre quienes trabajan con R y Python.
SQL Server, MySQL y Oracle tienen sus propias reglas y no se verificaron acá: lo que sigue vale para estos tres motores, y para cualquier otro la regla es probar antes de confiar.
2 · Dónde está cada cosa
| Cálculo | SQLite | PostgreSQL | DuckDB |
|---|---|---|---|
| Promedio | AVG(x) | AVG(x) | AVG(x) |
| Desvío muestral | no tiene | stddev_samp(x) | stddev_samp(x) |
| Desvío poblacional | no tiene | stddev_pop(x) | stddev_pop(x) |
| Percentil | no tiene | percentile_cont(0.25) WITHIN GROUP (ORDER BY x) | quantile_cont(x, 0.25) |
| Mediana | no tiene | percentile_cont(0.5) WITHIN GROUP (ORDER BY x) | median(x) |
| Contar filas / valores | COUNT(*) / COUNT(x) | igual | igual |
| Tasa de un grupo | 1000.0 * SUM(d) / SUM(n) | igual | igual |
| Unir tablas | JOIN, LEFT JOIN | igual | igual |
stddev(x), sin sufijo, es el muestral en PostgreSQL y en DuckDB: sobre las
mismas 12 edades de las otras entradas da 14,62, como R. SQLite no trae ninguna
función de desvío ni de percentiles: hay que calcularlos aparte o pasar los
datos a otro programa.
3 · Lo que cambia el resultado
La división entera: la tasa que da cero
Entre dos columnas de números enteros, SQLite y PostgreSQL hacen división
entera: descartan los decimales. Una tasa de mortalidad infantil escrita como
defunciones / nacimientos * 1000 divide 1.235 por 147.081, obtiene 0 y lo
multiplica por mil.
| SQLite | PostgreSQL | DuckDB | |
|---|---|---|---|
defunciones / nacimientos * 1000 | 0 | 0 | 8,40 |
1000.0 * defunciones / nacimientos | 8,40 | 8,40 | 8,40 |
5 / 2 | 2 | 2 | 2,5 |
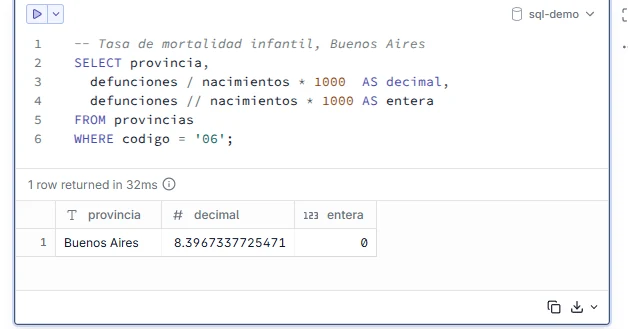
El arreglo es que uno de los términos sea decimal antes de dividir. Lo más
simple es poner 1000.0 adelante, como en la segunda fila. El orden importa:
defunciones / nacimientos * 1000.0 sigue dando cero, porque la división
entera ya ocurrió.
Convertir el tipo también funciona, pero no igual en todos lados:
| SQLite | PostgreSQL | DuckDB | |
|---|---|---|---|
CAST(defunciones AS NUMERIC) / nacimientos * 1000 | 0 | 8,40 | 8,40 |
CAST(defunciones AS REAL) / nacimientos * 1000 | 8,40 | 8,40 | 8,40 |
Para SQLite, un entero ya es «numérico», así que NUMERIC no cambia nada:
hace falta REAL.
Promediar tasas no da la tasa del grupo
AVG(tasa) promedia las tasas de las provincias como si todas pesaran lo
mismo. La tasa de una región es el total de defunciones sobre el total de
nacimientos:
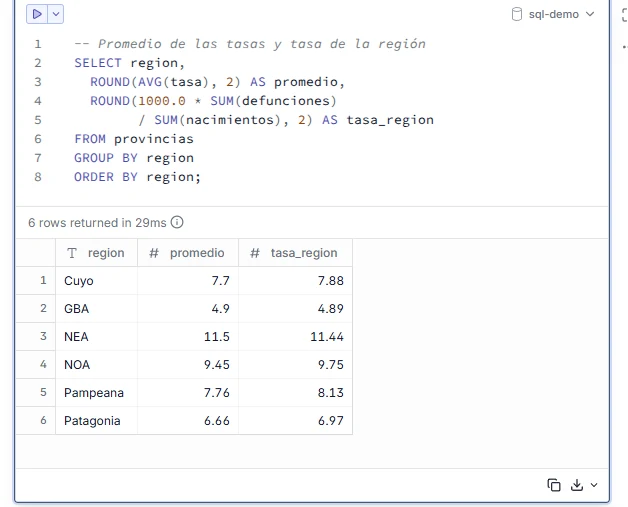
Es el mismo problema de la media ponderada, y el mismo que aparece en Power BI cuando se resume una columna de tasas con «Promedio».
El JOIN que duplica filas
Un JOIN devuelve una fila por cada par que coincide. Si una de las tablas
tiene varias filas por provincia, la otra se repite, y las sumas se inflan.
Al unir las provincias con los aglomerados de la EPH (Buenos Aires tiene
cuatro, Santa Fe tres), los nacimientos de la región Pampeana pasan de
230.254 a 785.344:
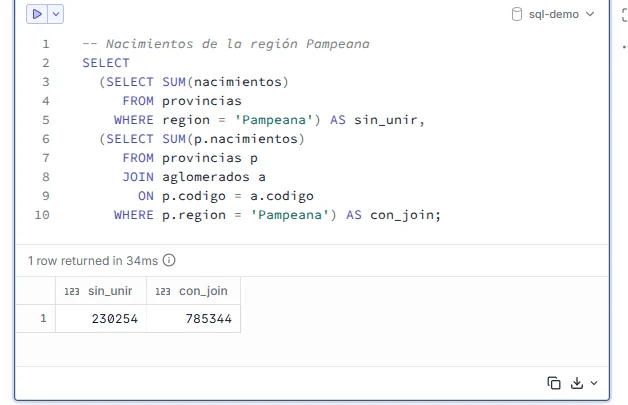
La tasa también se mueve, de 8,13 a 8,24, porque cada provincia queda pesada
por su cantidad de aglomerados. La regla práctica: antes de sumar, contar.
Si COUNT(*) después del JOIN no da las filas que había antes, la unión
multiplicó algo. Ver unir tablas.
NULL no es un valor
En SQL, NULL marca un dato faltante, y las reglas para tratarlo sorprenden:
| Consulta, sobre el ingreso con el −9 pasado a NULL | Resultado |
|---|---|
COUNT(*) | 631 |
COUNT(p21) | 601 |
AVG(p21) | $871.719 (promedia los 601) |
NULL = NULL | ni verdadero ni falso |
La que más confunde es NOT IN. Si la lista contra la que se compara tiene un
NULL, la consulta no devuelve ninguna fila: para SQL, «no está en la
lista» no se puede afirmar cuando la lista tiene un valor desconocido.
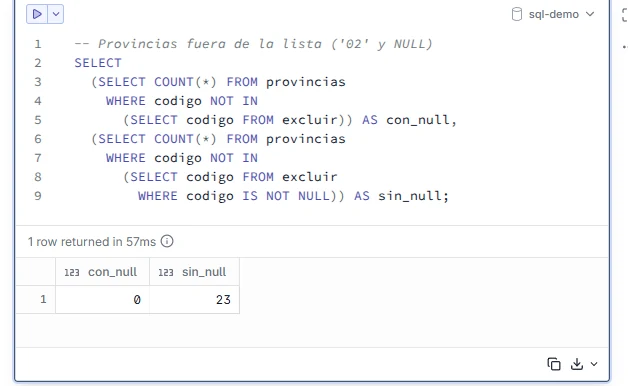
NOT EXISTS, o filtrar la lista con WHERE codigo IS NOT NULL, evita el
problema. Ver datos faltantes.
Códigos como texto y como número
Los códigos del INDEC tienen un cero adelante («06»). Guardados como texto en una tabla y como número en otra, la unión se comporta distinto según el motor:
JOIN de «06» (texto) con 6 (número) | Resultado |
|---|---|
| SQLite | une las 24 provincias: convierte el texto a número |
| DuckDB | une las 24 provincias |
| PostgreSQL | error: «operator does not exist: character varying = integer» |
El error de PostgreSQL es el mejor de los tres resultados: obliga a decidir. Los que convierten solos dan el número correcto acá, pero esconden el problema. Y un código guardado como texto sin el cero se ordena como texto: «10», «14», «18», «2»… en los tres motores.
El redondeo depende del tipo
ROUND(2.5) da 3 en los tres motores cuando el número es decimal exacto. En
PostgreSQL, si el número es de punto flotante (float8), da 2: redondea al
par, como R y Python. La misma función, en el mismo motor, redondea distinto
según cómo esté guardada la columna. Ver
redondeo.
Los percentiles
PostgreSQL y DuckDB ofrecen dos percentiles. El continuo
(percentile_cont, quantile_cont) interpola, y para el primer cuartil de las
12 edades da 30,75, igual que R y Excel. El discreto
(percentile_disc, quantile_disc) devuelve siempre un valor de los datos:
30. Ver cuantiles.
4 · Hasta dónde llega
SQL es la mejor herramienta para preparar los datos: filtrar, unir, agrupar y resumir millones de filas sin cargarlas en memoria. No tiene pruebas de hipótesis ni modelos. El flujo habitual es resumir en SQL y analizar en R o Python, que se conectan a cualquiera de estos motores; DuckDB, además, consulta directamente archivos CSV y Parquet sin importarlos.
5 · Errores frecuentes
- Dividir dos enteros. En SQLite y PostgreSQL, la tasa da cero. Un
1000.0adelante lo resuelve; en SQLite,CAST(... AS NUMERIC)no. - Promediar tasas. La tasa de un grupo es
SUMsobreSUM, noAVG. - Sumar después de un JOIN sin contar filas. Si la unión multiplicó filas, las sumas también.
- Usar
NOT INcontra una lista con NULL. No devuelve nada. - Comparar con
= NULL. Nunca es verdadero: se usaIS NULL. - Confiar en
COUNT(columna)como total de casos. No cuenta los NULL;COUNT(*)sí. - Guardar códigos como número. Se pierde el cero adelante y se rompen las uniones con tablas que lo tienen.
- Esperar desvío o percentiles en SQLite. No los trae.
Seguir leyendo
Bioestadística · Cómputo y comunicación · 288 de 322
Estadística para Economía y Administración · Cómputo y comunicación · 285 de 303
Probabilidad y Estadística · Cómputo y comunicación · 276 de 290
Cómo citar: Montivero, J. L. (2026). Estadística en SQL: qué hace cada motor por defecto. estadistica.ar. https://estadistica.ar/conceptos/estadistica-en-sql
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Estadística en SQL: qué hace cada motor por defecto. estadistica.ar. https://estadistica.ar/conceptos/estadistica-en-sql
BibTeX
@misc{estadistica_ar_estadistica_en_sql,
  author       = {Montivero, Jorge Luis},
  title        = {{Estadística en SQL: qué hace cada motor por defecto}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/estadistica-en-sql}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-10-01}
}
Última actualización: 1 de octubre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.