estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/modo
Modo (moda)
El valor que más se repite: la única medida de posición que sirve para variables nominales, y la que revela distribuciones con más de un pico.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
El modo —también llamado moda— es el valor o la categoría que aparece con mayor frecuencia.
2 · Para qué sirve
Tiene tres usos claros, y fuera de ellos aporta poco:
Variables cualitativas. Es la única opción disponible. “La categoría ocupacional más frecuente es obrero o empleado” es una afirmación sobre el modo.
Variables discretas con pocos valores. “El tamaño de hogar más frecuente es de 2 personas” se entiende mejor que cualquier promedio.
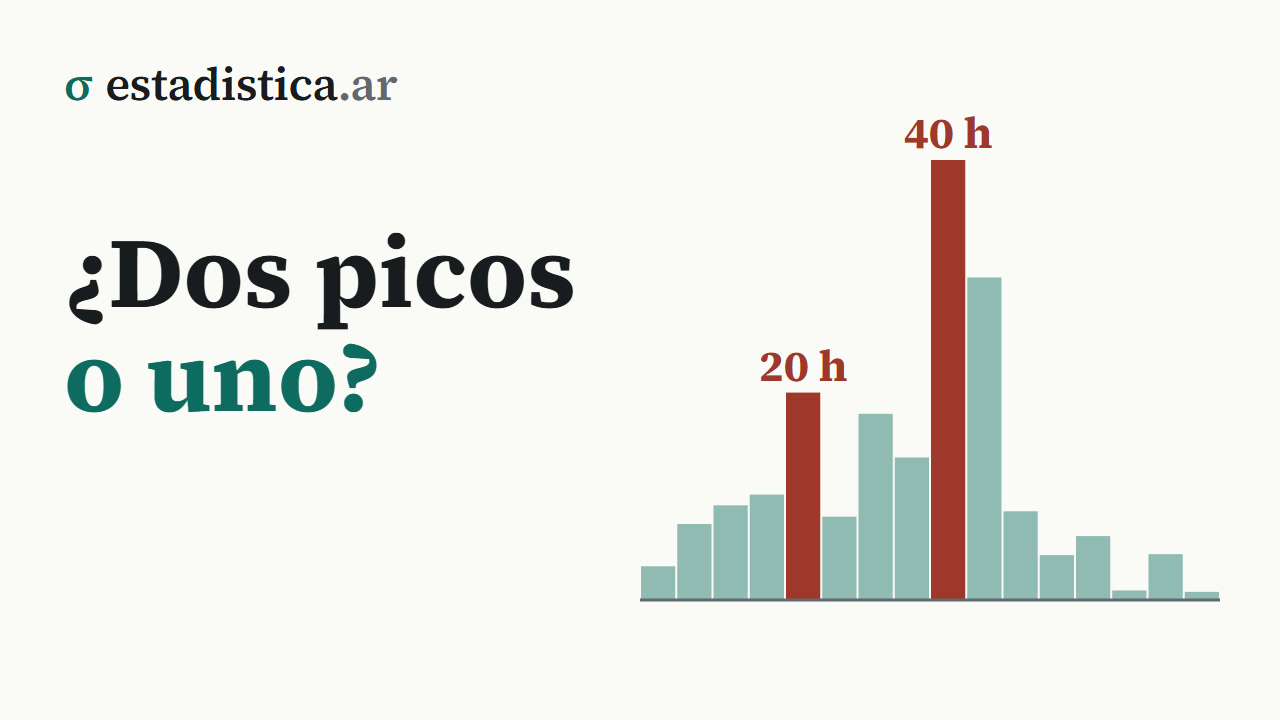
Detectar más de un pico. Si una distribución tiene dos modos claros, casi suele haber dos poblaciones mezcladas. Eso es una señal para separarlas, y ninguna otra medida de posición la da.
Lo que el modo no dice es cuánto domina esa categoría: “la más frecuente es X” vale igual si X tiene el 85 % o el 30 %. Esa diferencia se mide con los índices de dispersión cualitativa.
3 · Cómo se obtiene
No se calcula: se cuenta. Se arma la tabla de frecuencias y se busca el valor con mayor . Si los casos tienen ponderador, el modo es la categoría con mayor suma de pesos, que no siempre es la que tiene más filas en la base.
En datos agrupados en intervalos no se habla de modo sino de clase modal: el intervalo con mayor frecuencia. Con la edad de los ocupados agrupada en tramos de diez años, la clase modal es [35, 45), con el 25,7 % de los casos. Si hace falta un valor y no un intervalo, se lo ubica adentro de esa clase corriéndolo hacia la vecina más poblada —la fórmula está en datos agrupados—, y ahí da 37,7 años.
4 · Puede no haber, o haber varios
A diferencia de la media y la mediana, que siempre existen y son únicas, el modo tiene dos rarezas:
Puede no existir. Si ningún valor se repite —cosa habitual en variables continuas medidas con precisión— no hay modo. En el ingreso medido al peso, técnicamente casi no habría repeticiones.
Puede haber más de uno. Si dos o más valores empatan en la frecuencia máxima, hay varios modos. Cuando además son picos separados, la distribución se llama bimodal (o multimodal, con más de dos).
Y hay una tercera rareza, que es la que más confunde: en variables continuas la cantidad de picos depende de cómo se agrupe. El mismo conjunto de datos puede verse unimodal con seis clases y bimodal con veinte, sin que haya cambiado un solo valor. Por eso, antes de anunciar que una distribución es bimodal, conviene comprobar que los dos picos siguen ahí con distintos anchos de clase: un pico que aparece con un solo agrupamiento es ruido, no un grupo.
Lo mismo vale para el redondeo y la unidad: la edad en años cumplidos tiene un modo, la edad en quinquenios otro y la edad en décadas otro más. El modo es una propiedad de los datos tal como se registraron, no solo del fenómeno.
5 · Un ejemplo
Con el ingreso de la ocupación principal de la EPH, el valor más declarado es
$1.000.000, que concentra el 8,7 % de los ocupados con ingreso
(ponderados con PONDIIO).
Que un valor continuo tenga un modo tan marcado no es casualidad: es el amontonamiento en valores redondos. La gente declara 800.000 o 1.000.000, no 987.430. Ese comportamiento hace que variables continuas se comporten, en la práctica, como si tuvieran valores preferidos.
Con la edad de los ocupados de 15 a 74 años, el modo es 33 años, con el 2,92 % de los casos. Pero es un modo que casi no significa nada: 45 y 38 años tienen el 2,89 % cada una, y 40 el 2,80 %. La distribución tiene una meseta ancha entre los 30 y los 45, y cuál de esas edades queda arriba depende de pequeñas variaciones de la muestra. Con las 80 edades de ocupados que usa la calculadora del sitio, por ejemplo, el modo es 44 años, que aparece seis veces.
Y con las personas por hogar, el modo es 2 personas (24,4 % de los hogares), mientras que la mediana es 3 y la media 2,95. Las tres medidas dan valores distintos y las tres son correctas: responden preguntas distintas.
6 · Las tres medidas juntas
| Ingreso | Edad | Personas por hogar | |
|---|---|---|---|
| Modo | $1.000.000 | 33 años | 2 |
| Mediana | $900.000 | 40 años | 3 |
| Media | $1.104.227 | 41,0 años | 2,95 |
En el tamaño del hogar las tres están cerca. En la edad, la media y la mediana coinciden y el modo se aleja, pero solo porque el pico es una meseta casi empatada. En el ingreso, la media se despega hacia arriba: es la firma de una distribución asimétrica a la derecha.
7 · Errores frecuentes
- Confundir el modo con su frecuencia. Si “secundario completo” aparece 4.210.831 veces, el modo es secundario completo, no 4.210.831. El modo es el valor, no cuántas veces está.
- Creer que siempre hay un modo. Si todos los valores aparecen la misma cantidad de veces, o si ninguno se repite, no lo hay.
- Buscar el modo en una variable continua medida con precisión. Ahí conviene hablar de clase modal. La excepción es cuando las respuestas se amontonan en valores redondos, como el ingreso: ese modo sí dice algo, aunque sea sobre cómo declara la gente.
- Mezclar el modo de los datos y el de la tabla agrupada. Son dos números distintos que responden preguntas distintas; hay que decir cuál se informa.
- Anunciar bimodalidad sin probar otro agrupamiento. Un segundo pico que desaparece al cambiar el ancho de clase no era un grupo.
- Usarlo como medida principal en variables cuantitativas. Salvo para discretas con pocos valores, el modo aporta menos que la media o la mediana.
- Ignorar la bimodalidad. Es lo más informativo que puede decir el modo, y se pasa por alto porque el software devuelve un solo valor.
- Decir “la moda es 44 y 45” cuando solo uno tiene la frecuencia máxima. Empate es empate exacto.
8 · En el software
# R no tiene función de modo: `mode()` devuelve el tipo del objeto
which.max(table(datos$edad))            # el valor más frecuente
sort(table(datos$edad), decreasing = TRUE)[1:5]   # mejor: mirar los cinco

# Con ponderadores, la categoría con más peso
sort(xtabs(PONDERA ~ nivel, datos), decreasing = TRUE)[1]
# Python
datos["edad"].mode() # devuelve todos los modos si hay empate
datos["edad"].value_counts().head()
# Ponderado
datos.groupby("nivel")["PONDERA"].sum().idxmax()Excel: =MODA.UNO(rango) un solo modo: si hay empate, el que aparece
primero en el rango; #N/A si nada se repite
=MODA.VARIOS(rango) matricial, devuelve todos
Las dos funciones solo trabajan con números: para categorías
con texto va una tabla dinámica o CONTAR.SI por categoría
SPSS: Frecuencias › Estadísticos › Moda
(si hay empate, muestra el menor y avisa al pie)
InfoStat: Estadísticas › Medidas resumenHerramientas de este tema
- CalculadoraDescriptivos desde datos pegados
Seguir leyendo
Bioestadística · Fundamentos y descripción · 31 de 330
Estadística para Economía y Administración · Fundamentos y descripción · 30 de 318
Probabilidad y Estadística · Fundamentos y descripción · 31 de 302
Estadística para Ciencias Sociales · Fundamentos y descripción · 29 de 288
Estadística para la tesis · Los datos · 80 de 233
Cómo citar: Montivero, J. L. (2026). Modo (moda). estadistica.ar. https://estadistica.ar/conceptos/modo
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Modo (moda). estadistica.ar. https://estadistica.ar/conceptos/modo
BibTeX
@misc{estadistica_ar_modo,
  author       = {Montivero, Jorge Luis},
  title        = {{Modo (moda)}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/modo}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-11-09}
}
Última actualización: 9 de noviembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.