estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/analisis-de-decision
Análisis de decisión
Cómo elegir entre alternativas cuando el resultado depende de algo incierto: tabla de pagos, criterios, árbol de decisión y cuánto vale la información.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · El problema
Hay que elegir ahora entre varias alternativas, y lo que cada una rinda depende de algo que se va a saber después. El análisis de decisión ordena ese problema en tres piezas:
| Pieza | Qué es | Quién la controla |
|---|---|---|
| Alternativas | Las acciones posibles | Quien decide |
| Estados de la naturaleza | Lo que puede pasar: exhaustivos y mutuamente excluyentes | Nadie |
| Resultados (pagos) | Lo que se gana o se pierde con cada combinación | La cuenta |
Una hostería de la provincia evalúa ampliarse antes de la temporada. Puede no ampliar, hacer una ampliación chica o una grande, y lo que le convenga depende de cómo venga la demanda en los próximos años. El resultado neto de cada combinación, en millones de pesos:
| Demanda alta | Demanda media | Demanda baja | |
|---|---|---|---|
| No ampliar | 10 | 10 | 10 |
| Ampliación chica | 30 | 18 | −5 |
| Ampliación grande | 55 | 15 | −30 |
Esa es la tabla de pagos. Ninguna alternativa gana en todos los estados, y ese es el problema: si una ganara siempre (si dominara a las demás), no habría nada que decidir.
2 · Decidir sin probabilidades
Si no hay ninguna idea de qué tan probable es cada estado, hay criterios que deciden con la tabla sola. Cada uno expresa una actitud distinta frente a la incertidumbre:
- Maximin (pesimista): mirar el peor resultado de cada alternativa y elegir el mejor de esos peores. Peores: 10, −5 y −30 → no ampliar.
- Maximax (optimista): mirar el mejor resultado de cada una y elegir el mejor de los mejores. Mejores: 10, 30 y 55 → ampliación grande.
- Laplace: tratar los estados como igualmente probables y promediar. Promedios: 10; 14,3; 13,3 → ampliación chica.
- Minimax arrepentimiento (Savage): medir cuánto se pierde, en cada estado, por no haber elegido lo mejor para ese estado, y minimizar el peor arrepentimiento.
- Hurwicz: ponderar el mejor y el peor resultado con un coeficiente de optimismo , entre 0 y 1.
El arrepentimiento (o pérdida de oportunidad) se arma restando cada pago del mejor de su columna:
| Arrepentimiento | Alta | Media | Baja | Máximo |
|---|---|---|---|---|
| No ampliar | 45 | 8 | 0 | 45 |
| Ampliación chica | 25 | 0 | 15 | 25 |
| Ampliación grande | 0 | 3 | 40 | 40 |
El menor de los máximos es 25 → ampliación chica: es la alternativa con la que, pase lo que pase, uno menos se lamenta.
Con Hurwicz, el valor de cada alternativa es , y la decisión cambia según cuánto optimismo se declare:
| Elige | |
|---|---|
| menos de 0,429 | No ampliar |
| entre 0,429 y 0,5 | Ampliación chica |
| más de 0,5 | Ampliación grande |
3 · Decidir con probabilidades: el valor esperado
Si se pueden asignar probabilidades a los estados, el criterio estándar es elegir la alternativa de mayor valor esperado, que es la esperanza matemática del resultado:
La hostería estima, con lo que sabe del mercado, 0,3 de demanda alta, 0,5 de media y 0,2 de baja. Son probabilidades subjetivas en el sentido de las definiciones de probabilidad: no hay una frecuencia que observar, hay un juicio informado.
El valor esperado elige la ampliación grande, por un margen chico: 18 contra 17.
4 · El árbol de decisión
La misma información se dibuja como un árbol que se lee de izquierda a derecha, en el orden en que ocurren las cosas:
- un cuadrado es un nodo de decisión: ahí elige quien decide;
- un círculo es un nodo de azar: ahí elige la naturaleza, con las probabilidades escritas en sus ramas;
- al final de cada camino está el resultado.
El árbol se resuelve de derecha a izquierda (inducción hacia atrás): cada círculo se reemplaza por el valor esperado de sus ramas, y cada cuadrado por la mejor de las suyas. Con un solo nivel de decisión, como acá, el árbol no agrega nada a la tabla. Su ventaja aparece cuando hay decisiones encadenadas, por ejemplo decidir primero si conviene averiguar algo y recién después qué hacer, que es el problema de la sección 7.
5 · Análisis de sensibilidad
Las probabilidades son estimaciones, así que hay que preguntarse cuánto tendrían que cambiar para que cambie la decisión. Dejando la probabilidad de demanda baja fija en 0,2 y moviendo la de demanda alta, , el valor esperado de cada alternativa es una recta:
Se cortan en .
6 · El valor esperado de la información perfecta
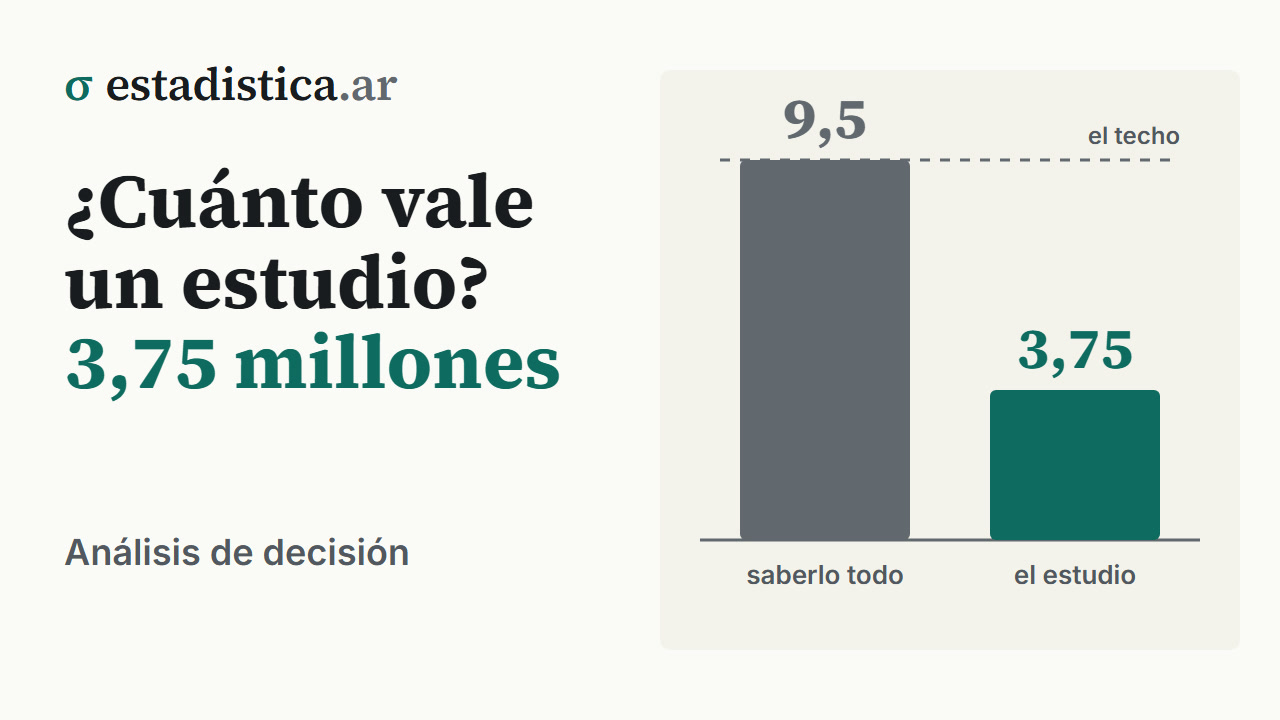
Supóngase que alguien supiera de antemano, sin error, qué demanda va a venir. Con demanda alta se elegiría la grande (55), con media la chica (18) y con baja no ampliar (10). Antes de saber qué le van a decir, eso vale:
La diferencia con lo mejor que se puede hacer sin información es el valor esperado de la información perfecta:
El VEIP también es igual al arrepentimiento esperado de la mejor alternativa: . No es casualidad: lo que vale saber es exactamente lo que se espera perder por no saber.
7 · Información muestral y Bayes
La información real nunca es perfecta. Un estudio de mercado puede dar favorable o desfavorable, y por la experiencia de la consultora se sabe qué tan seguido acierta en cada situación:
| Demanda alta | Demanda media | Demanda baja | |
|---|---|---|---|
| 0,8 | 0,5 | 0,1 |
Para decidir hace falta lo inverso: dado lo que dijo el estudio, qué tan probable es cada estado. Es exactamente el problema del teorema de Bayes, con el denominador por probabilidad total:
| Alta | Media | Baja | Total | |
|---|---|---|---|---|
| Conjunta con «favorable» | 0,24 | 0,25 | 0,02 | 0,51 |
| Posterior dado «favorable» | 0,471 | 0,490 | 0,039 | 1 |
| Conjunta con «desfavorable» | 0,06 | 0,25 | 0,18 | 0,49 |
| Posterior dado «desfavorable» | 0,122 | 0,510 | 0,367 | 1 |
Con cada juego de posteriores se recalcula el valor esperado de las tres alternativas:
| Resultado del estudio | No ampliar | Chica | Grande | Decisión |
|---|---|---|---|---|
| Favorable (0,51) | 10 | 22,75 | 32,06 | Ampliación grande |
| Desfavorable (0,49) | 10 | 11,02 | 3,37 | Ampliación chica |
Eso es una estrategia de decisión: una regla que dice qué hacer ante cada resultado posible, decidida antes de verlo. Su valor esperado pondera cada rama por la probabilidad de que el estudio dé ese resultado:
y el valor esperado de la información muestral es lo que el estudio agrega sobre decidir sin él:
El estudio vale porque puede cambiar la decisión: con un resultado desfavorable lleva a la ampliación chica. Un estudio cuyos dos resultados llevaran a la misma alternativa valdría exactamente cero, por preciso que fuera.
8 · Errores frecuentes
- Confundir el valor esperado con lo que va a pasar. El 18 de la ampliación grande no es un resultado posible: los posibles son 55, 15 y −30.
- Decidir por valor esperado cuando el riesgo importa. Con una decisión que se toma una sola vez y una pérdida que no se puede absorber, dos alternativas con el mismo valor esperado no son equivalentes.
- Pagar por información que no cambia la decisión. Si todos los resultados posibles del estudio llevan a la misma alternativa, su valor es cero.
- Usar como si fuera . El 0,8 de acierto con demanda alta no es la probabilidad de demanda alta cuando el estudio da favorable: esa es 0,471. Es la misma inversión indebida que en el teorema de Bayes.
- Comparar el VEIM con el precio del estudio sin restar. El VEIM ya es la ganancia neta de la información respecto de no tenerla; lo que se compara con él es el costo, no el VECIM.
- No hacer análisis de sensibilidad. Las probabilidades de los estados son juicios; una decisión que se da vuelta con un cambio de 0,04 no se puede presentar como si fuera firme.
- Omitir estados o alternativas. Los estados tienen que ser exhaustivos y mutuamente excluyentes, y una alternativa olvidada no la rescata ningún criterio.
9 · En el software
# R — la tabla de pagos es una matriz y todo lo demás son cuentas
pagos <- matrix(c(10, 10, 10,
                  30, 18, -5,
                  55, 15, -30), nrow = 3, byrow = TRUE,
                dimnames = list(c("no", "chica", "grande"),
                                c("alta", "media", "baja")))
previa <- c(0.3, 0.5, 0.2)

apply(pagos, 1, min)                    # maximin: 10 -5 -30
arrep <- sweep(-pagos, 2, apply(pagos, 2, max), "+")
apply(arrep, 1, max)                    # minimax arrepentimiento: 45 25 40

ve   <- pagos %*% previa                # 10 17 18
veip <- sum(apply(pagos, 2, max) * previa) - max(ve)   # 9.5

# Información muestral
p_fav  <- c(0.8, 0.5, 0.1)
vecim  <- 0
for (lk in list(p_fav, 1 - p_fav)) {
  conj  <- previa * lk
  post  <- conj / sum(conj)             # Bayes
  vecim <- vecim + sum(conj) * max(pagos %*% post)
}
vecim - max(ve)                         # VEIM: 3.75
# Python
import numpy as np
pagos = np.array([[10, 10, 10], [30, 18, -5], [55, 15, -30]])
previa = np.array([0.3, 0.5, 0.2])
ve = pagos @ previa # [10, 17, 18]
veip = (pagos.max(axis=0) * previa).sum() - ve.max() # 9.5
p_fav = np.array([0.8, 0.5, 0.1])
vecim = sum((previa * lk).sum() * (pagos @ (previa * lk / (previa * lk).sum())).max()
for lk in (p_fav, 1 - p_fav))
vecim - ve.max() # 3.75Seguir leyendo
Estadística para Economía y Administración · Azar y modelos · 125 de 318
Probabilidad y Estadística · Azar y modelos · 104 de 302
Cómo citar: Montivero, J. L. (2026). Análisis de decisión. estadistica.ar. https://estadistica.ar/conceptos/analisis-de-decision
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Análisis de decisión. estadistica.ar. https://estadistica.ar/conceptos/analisis-de-decision
BibTeX
@misc{estadistica_ar_analisis_de_decision,
  author       = {Montivero, Jorge Luis},
  title        = {{Análisis de decisión}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/analisis-de-decision}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-10-30}
}
Última actualización: 30 de octubre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.