estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/distribucion-uniforme
Distribución uniforme
Cuando todos los valores son igualmente probables: la versión discreta, la continua, y su papel como base de toda simulación.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · Definición
La distribución uniforme es aquella en la que todos los valores posibles tienen la misma probabilidad —si es discreta— o la misma densidad —si es continua—.
Discreta, sobre valores:
Continua, sobre el intervalo :
2 · Media y varianza
Para la continua en :
La media es el punto medio, como cabía esperar de algo simétrico. El 12 del denominador sale de integrar; no tiene una interpretación intuitiva y no hace falta recordar de dónde viene.
Para la discreta sobre :
3 · Probabilidades: es pura proporción
En la uniforme continua, la probabilidad de un intervalo es su longitud relativa:
Si un colectivo pasa cada 10 minutos y se llega a la parada en un momento cualquiera, la espera es : esperar entre 2 y 5 minutos tiene probabilidad , y la espera media es 5 minutos con desvío .
4 · Dónde aparece
Como modelo de una situación real, poco: casi nada en la naturaleza es uniforme. Los casos legítimos son artificiales —un dado equilibrado, una ruleta, el instante de llegada a una parada, el error de redondeo—.
Como supuesto de partida, mucho:
- Selección aleatoria. Un muestreo aleatorio simple es, por definición, dar probabilidad uniforme a todas las unidades del marco.
- Hipótesis nula de uniformidad. La prueba de bondad de ajuste suele contrastar contra “todas las categorías son igualmente frecuentes”.
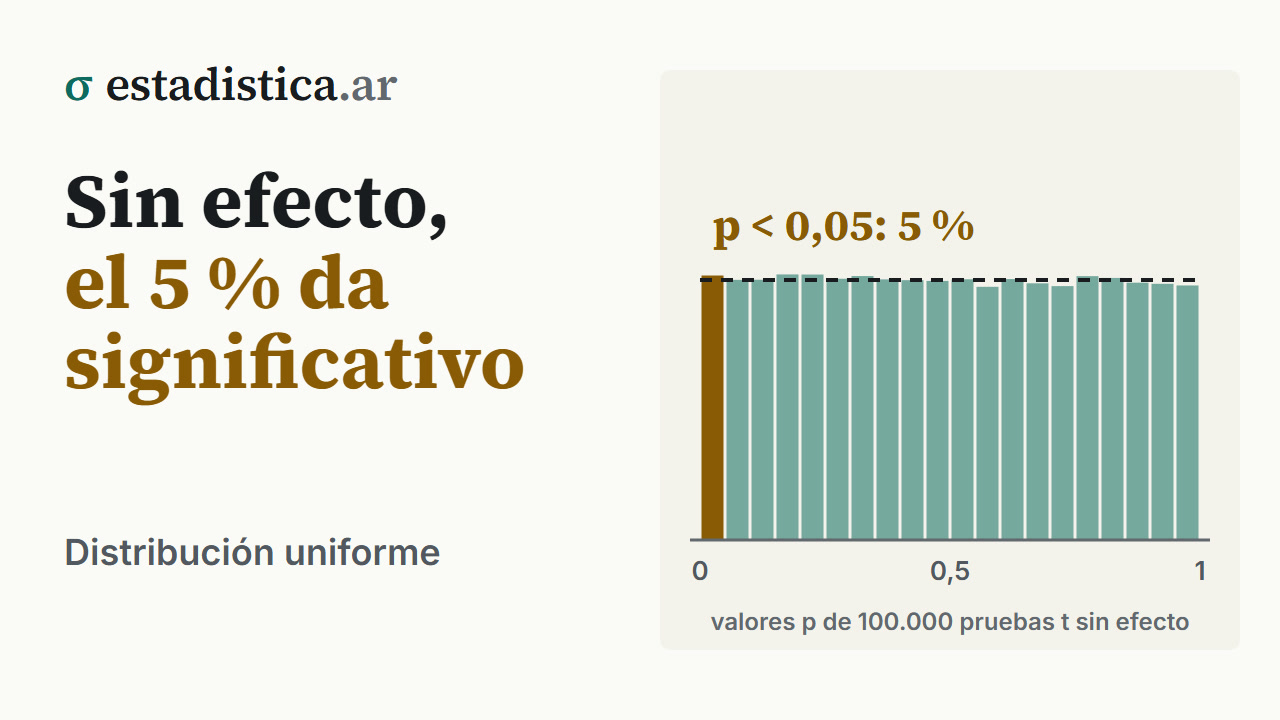
- Los valores p. Bajo la hipótesis nula, un valor p se distribuye uniforme en . De ahí que rechazar con dé 5 % de error de tipo I.
Ese último es el más importante y se puede comprobar. Cien mil pruebas t entre dos grupos generados de la misma distribución, o sea con la hipótesis nula verdadera:
| Umbral | Proporción de valores p por debajo |
|---|---|
| 0,01 | 0,0097 |
| 0,05 | 0,0504 |
| 0,10 | 0,1003 |
| 0,25 | 0,2522 |
| 0,50 | 0,5027 |
El error de redondeo. Redondear a la unidad equivale a sumarle a cada dato un error uniforme en , cuya varianza es . Simulando 500.000 estaturas, la varianza pasa de 99,86 a 99,94: 0,079 de más, lo que predice la fórmula. Es exactamente el fundamento de la corrección de Sheppard.
5 · La base de toda simulación
Todo generador de números aleatorios produce, en el fondo, valores . El resto de las distribuciones se obtiene transformándolos.
El método más general es la transformación inversa: si ,
entonces tiene distribución . Es exactamente lo que hace
qnorm(runif(1)) y lo que está detrás de rnorm, rbinom y de todo el
remuestreo. La propiedad que lo garantiza está en
la función acumulada.
6 · Errores frecuentes
- Suponer uniformidad sin verificarla. Que no se sepa nada de una variable no la vuelve uniforme; suponer uniforme es un supuesto fuerte, no neutral.
- Confundir la densidad con una probabilidad. En la densidad vale 2, y una densidad mayor que 1 es perfectamente válida.
- Usar la discreta con categorías de distinta “anchura”.
- Creer que los números aleatorios de la computadora son aleatorios. Son pseudoaleatorios: con la misma semilla dan la misma secuencia. Eso es una ventaja, porque hace reproducible el análisis.
- Olvidar la semilla. Sin
set.seed()los resultados de una simulación no se pueden replicar.
7 · En el software
# R — continua
dunif(3, min = 0, max = 10)       # densidad = 0.1
punif(5, 0, 10)                   # P(X ≤ 5) = 0.5
runif(100, 0, 10)                 # 100 valores uniformes

set.seed(2026)                    # para que sea reproducible

# Discreta: elegir al azar entre 1 y 6
sample(1:6, 1)
# Python
from scipy import stats
import numpy as np
stats.uniform.cdf(5, loc=0, scale=10)
rng = np.random.default_rng(2026)
rng.uniform(0, 10, 100)
rng.integers(1, 7, 100) # dadoExcel: =ALEATORIO() un U(0,1)
=ALEATORIO.ENTRE(1; 6) uniforme discretaHerramientas de este tema
- SimuladorExplorador de distribuciones
Seguir leyendo
Bioestadística · Azar y modelos · 126 de 330
Estadística para Economía y Administración · Azar y modelos · 131 de 318
Probabilidad y Estadística · Azar y modelos · 110 de 302
Cómo citar: Montivero, J. L. (2026). Distribución uniforme. estadistica.ar. https://estadistica.ar/conceptos/distribucion-uniforme
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Distribución uniforme. estadistica.ar. https://estadistica.ar/conceptos/distribucion-uniforme
BibTeX
@misc{estadistica_ar_distribucion_uniforme,
  author       = {Montivero, Jorge Luis},
  title        = {{Distribución uniforme}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/distribucion-uniforme}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-09-18}
}
Última actualización: 18 de septiembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.