estadistica.ar · Enciclopedia de Estadística en españolhttps://estadistica.ar/conceptos/sensibilidad-especificidad-y-vpp
Sensibilidad, especificidad y valor predictivo
Las cuatro medidas de una prueba diagnóstica, cuál mira el clínico y cuál el laboratorio, y por qué solo dos dependen de la prevalencia.
Por Jorge Luis Montivero, Licenciado en Estadística · Mu3Sigma
1 · La tabla de 2×2
Toda prueba diagnóstica se evalúa cruzando su resultado con la condición real:
| Enfermo | Sano | |
|---|---|---|
| Prueba + | Verdadero positivo (VP) | Falso positivo (FP) |
| Prueba − | Falso negativo (FN) | Verdadero negativo (VN) |
De ahí salen cuatro medidas, todas condicionales, y lo único que las distingue es por dónde se condiciona.
2 · Las cuatro medidas
Se condiciona por la enfermedad —se lee la tabla por columnas—:
Se condiciona por el resultado —se lee por filas—:
3 · Quién usa cada una
| Pregunta | Medida | Quién la necesita |
|---|---|---|
| ¿La prueba detecta a los enfermos? | Sensibilidad | quien elige la prueba |
| ¿Descarta bien a los sanos? | Especificidad | quien elige la prueba |
| Salió positivo, ¿estoy enfermo? | VPP | el paciente y el clínico |
| Salió negativo, ¿estoy tranquilo? | VPN | el paciente y el clínico |
El dato que aparece en el prospecto de la prueba es el de las dos primeras. El que le importa a la persona que recibió el resultado es el de las dos últimas, y no se puede calcular sin conocer la prevalencia.
4 · Solo dos dependen de la prevalencia
Es la propiedad central del tema.
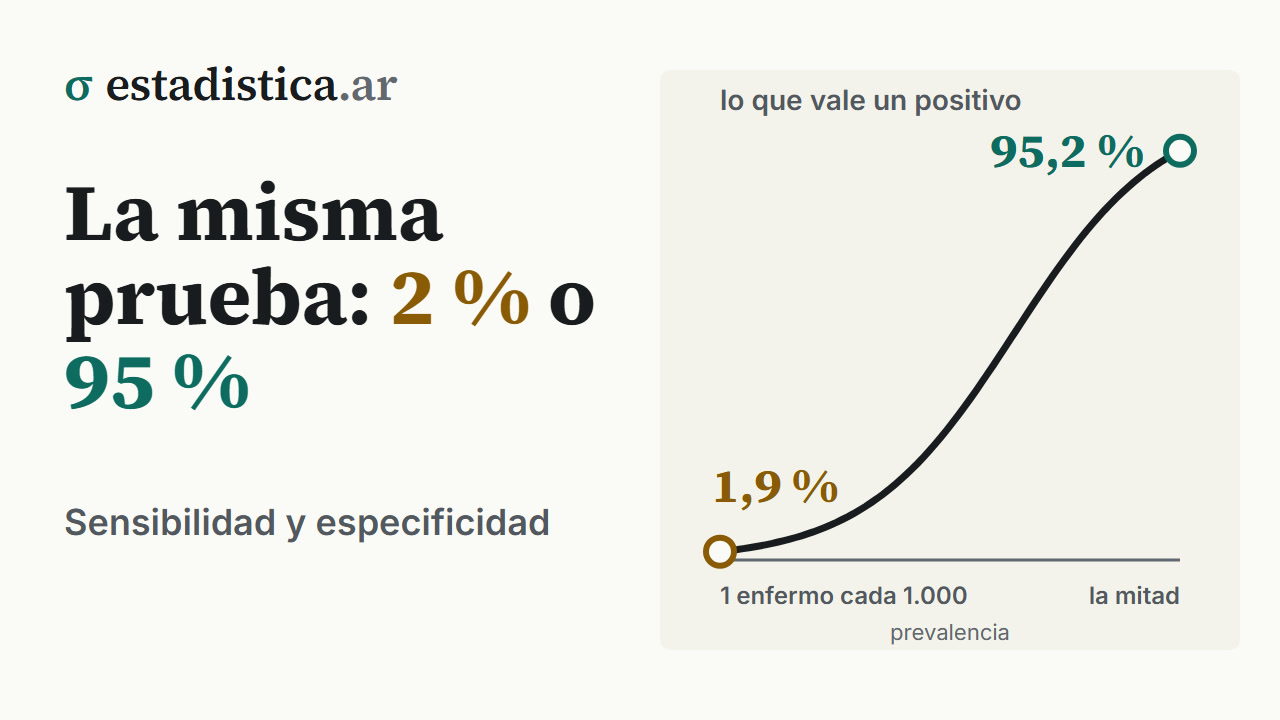
La sensibilidad y la especificidad son propiedades de la prueba: no cambian según a quién se le aplique. Los valores predictivos sí cambian, y mucho.
Con una prueba de sensibilidad 99 % y especificidad 95 %:
| Prevalencia | VPP | VPN | Falsos positivos por acierto |
|---|---|---|---|
| 0,1 % | 1,9 % | 100,00 % | 50,5 |
| 1 % | 16,7 % | 99,99 % | 5,0 |
| 5 % | 51,0 % | 99,94 % | 1,0 |
| 10 % | 68,7 % | 99,88 % | 0,5 |
| 30 % | 89,5 % | 99,55 % | 0,1 |
| 50 % | 95,2 % | 98,96 % | 0,1 |
5 · Las razones de verosimilitud
Hay un par de medidas más que combinan las dos primeras y tampoco dependen de la prevalencia:
Se leen como “cuántas veces más esperable es este resultado en un enfermo que en un sano”, y su utilidad es que se multiplican por los odds previos para obtener la respuesta del paciente, sin recalcular nada. Ver Bayes en odds.
| Qué tan concluyente es un positivo | |
|---|---|
| Más de 10 | fuerte |
| 5 a 10 | moderada |
| 2 a 5 | débil |
| Cerca de 1 | no aporta nada |
6 · El compromiso entre las dos
Cuando la prueba se basa en un punto de corte sobre una medición continua —glucemia, presión, un puntaje—, mover el corte mejora una medida y empeora la otra:
- Corte más exigente → más sensibilidad, menos especificidad: se detectan más enfermos y también más falsos positivos.
- Corte menos exigente → al revés.
La curva ROC es exactamente ese recorrido, y elegir el punto de corte es una decisión sobre cuál error cuesta más: no detectar una enfermedad grave y tratable, o alarmar y someter a estudios innecesarios a gente sana.
7 · Por qué la exactitud no sirve sola
La medida más intuitiva —qué porcentaje de casos se clasifica bien— es la que más engaña cuando la condición es poco frecuente:
| Situación, prevalencia 1 por mil | Exactitud |
|---|---|
| Decir “sano” a todo el mundo, sin hacer nada | 0,9990 |
| La prueba real, con sensibilidad 99 % y especificidad 95 % | 0,9500 |
En aprendizaje automático estas medidas tienen otros nombres —recall es la sensibilidad y precision es el VPP— y se suman el F1 y el lift: ver precisión, recall, F1 y lift.
8 · Un ejemplo fuera de la medicina
El esquema sirve para cualquier clasificador. En la tabla de la EPH, tomando “no haber terminado el secundario” como señal para detectar empleo no registrado:
| Medida | Valor |
|---|---|
| Prevalencia | 0,3764 |
| Sensibilidad | 0,3968 |
| Especificidad | 0,8330 |
| VPP | 0,5891 |
| VPN | 0,6958 |
| 2,38 | |
| 0,72 | |
| Exactitud | 0,6688 |
Especificidad alta y sensibilidad baja: la señal casi no se equivoca al descartar, pero deja pasar a seis de cada diez trabajadores no registrados.
9 · Errores frecuentes
- Confundir sensibilidad con VPP. El error central: son condicionales inversas.
- Reportar solo la sensibilidad. Una prueba que da positivo siempre tiene sensibilidad 100 % y es inútil.
- Reportar solo la exactitud, que con clases desbalanceadas premia al clasificador que no detecta nada.
- Olvidar la prevalencia al interpretar un resultado individual.
- Comparar valores predictivos entre poblaciones con distinta prevalencia como si midieran calidad de la prueba.
- Creer que un corte se elige estadísticamente. Se elige según el costo relativo de los dos errores, que es una decisión clínica o política.
- Extrapolar la sensibilidad de un estudio a otra población con distinto espectro de gravedad; en la práctica también varía algo.
10 · En el software
# R — a partir de una tabla 2x2
tab <- table(prueba, enfermedad)
sens <- tab["+", "enfermo"] / sum(tab[, "enfermo"])
esp  <- tab["-", "sano"]    / sum(tab[, "sano"])
vpp  <- tab["+", "enfermo"] / sum(tab["+", ])
lr_mas <- sens / (1 - esp)

# Control: comparar la exactitud contra la del clasificador trivial
max(mean(enfermedad == "enfermo"), mean(enfermedad == "sano"))

# Paquetes con todo calculado e IC
# epiR::epi.tests(tab)  ·  caret::confusionMatrix(tab)
# Python
from sklearn.metrics import confusion_matrix
vn, fp, fn, vp = confusion_matrix(y_real, y_pred).ravel()
sens = vp / (vp + fn)
esp = vn / (vn + fp)
vpp = vp / (vp + fp)Herramientas de este tema
- CalculadoraCurva ROC y punto de corte
- CalculadoraSensibilidad, especificidad y VPP
Seguir leyendo
Bioestadística · Azar y modelos · 110 de 330
Estadística para Economía y Administración · Azar y modelos · 113 de 318
Probabilidad y Estadística · Azar y modelos · 92 de 302
Estadística para la tesis · El análisis · 126 de 233
Cómo citar: Montivero, J. L. (2026). Sensibilidad, especificidad y valor predictivo. estadistica.ar. https://estadistica.ar/conceptos/sensibilidad-especificidad-y-vpp
estadistica.ar es gratuita y sin publicidad. Si te sirvió, podés invitar un cafecito por transferencia al alias mu3sigma. Asesoramiento estadístico, encuestas y capacitaciones: m3s.pro · WhatsApp +54 9 383 499-7929.
Cómo citar esta entrada
APA (7.ª edición)
Montivero, J. L. (2026). Sensibilidad, especificidad y valor predictivo. estadistica.ar. https://estadistica.ar/conceptos/sensibilidad-especificidad-y-vpp
BibTeX
@misc{estadistica_ar_sensibilidad_especificidad_y_vpp,
  author       = {Montivero, Jorge Luis},
  title        = {{Sensibilidad, especificidad y valor predictivo}},
  year         = {2026},
  howpublished = {\url{https://estadistica.ar/conceptos/sensibilidad-especificidad-y-vpp}},
  note         = {estadistica.ar. Consultado el \today},
  urldate      = {2026-09-28}
}
Última actualización: 28 de septiembre de 2026. El contenido está bajo licencia CC BY-NC-SA 4.0: se puede reutilizar citando la fuente y sin fines comerciales.